토큰 아끼는 이미지 생성, Mac 로컬 Animagine XL 3일 후기
ChatGPT 유료 플랜 대신 M1 Pro 맥북에서 Animagine XL 4.0으로 약 270장을 뽑았다. 77토큰 함정, 장당 108초를 59초로 줄인 설정, 생성 횟수를 줄인 합성 방식, 실제 토큰 집계까지.
ChatGPT 유료 플랜을 쓰면 이미지를 더 빠르게, 더 좋은 품질로 뽑을 수 있다. 그걸 알면서도 그림은 Mac 로컬 모델로 돌렸다. 토큰을 아껴야 했고, ChatGPT 유료 계정도 없었다. AI 코딩 에이전트에게는 프롬프트와 배치 같은 글자만 맡기고, 몇 번이고 다시 뽑아야 하는 생성은 내 GPU가 하게 했다. Animagine XL 4.0으로 3일 동안 약 270장을 뽑은 기록이다.
| 구분 | 내용 |
|---|---|
| 선택지 | ChatGPT 유료 이미지 생성. 빠르고 품질도 좋다 |
| 안 쓴 이유 | 토큰을 아껴야 했고, 유료 계정이 없었다 |
| 해결 | 생성은 Mac 로컬 Animagine XL 4.0, Claude는 프롬프트·레이아웃 JSON만 작성 |
| 결과 | 장당 약 60초로 클라우드보다 느리다. 대신 생성 토큰 0, 3일간 약 270장 |
🤔 ChatGPT가 더 빠르고 좋은데 왜 로컬로 돌렸나
솔직히 속도와 품질만 보면 ChatGPT 유료 플랜이 낫다. 기다릴 것도 거의 없고, 한 장면에 여러 사람을 넣어도 잘 그린다. 그래도 쓰지 않은 이유는 두 가지다.
첫째, 이미지 생성은 반복 작업이다. 한 번에 끝나는 그림이 거의 없다. 손가락이 6개거나, 안경이 사라지거나, 표정이 의도와 다르다. 결국 한 장면에 2~4장씩 뽑아서 고른다. 고르고 나서도 조금 고치고 싶으면 또 뽑는다. 클라우드에서는 이 반복이 고스란히 구독 사용 한도나 API 토큰으로 나간다.
둘째, ChatGPT 유료 계정이 없었다. 이미 쓰는 Claude Code에 GPU 달린 Mac이 있으니, 새 구독을 늘리기보다 있는 걸로 해결하고 싶었다.
그래서 느린 걸 감수하기로 했다. 대신 역할을 이렇게 나눴다.
- Claude Code는 생성 프롬프트와 장면 배치(레이아웃 JSON)를 텍스트로만 쓴다.
- 그림은 맥북의 내장 GPU에서 로컬 모델이 뽑는다. 열 번을 다시 뽑아도 토큰이 안 든다.
- 글자 얹기, 크기 맞추기, 합성은 파이썬 코드가 처리한다.
유료 클라우드는 빠르고, 로컬은 공짜다. 반복이 많은 작업이라 속도보다 토큰을 택했다.
기다리는 시간도 생각보다 덜 아까웠다. 생성을 백그라운드로 걸어 두고 그동안 다음 장면 프롬프트를 쓰면 된다.
🖥️ 셋업: 도커 없이 Mac에 바로 깔았다
환경은 2021년형 M1 Pro 맥북 프로다. 따로 꽂는 그래픽카드는 없다. 칩 안에 14코어 GPU가 들어 있고, 메모리 32GB를 CPU와 GPU가 같이 쓴다. NVIDIA 그래픽카드보다 한참 느리지만, 통합 메모리 덕분에 7GB짜리 모델을 통째로 올려도 메모리가 모자라지 않았다. PyTorch는 MPS라는 통로로 이 GPU를 쓴다.
처음엔 도커로 감싸려다 접었다. 도커 컨테이너 안에서는 Apple GPU(MPS)를 못 쓴다. CPU로만 돌면 한 장에 수십 분이 걸린다. 로컬이 느리다는 단점을 더 키울 이유가 없었다.
| 구성 요소 | 역할 | 크기 |
|---|---|---|
| Animagine XL 4.0 | SDXL을 애니 그림으로 추가 학습한 본체 모델 | 약 7GB |
| IP-Adapter | 참고 이미지를 닮게 해 주는 보조 모델 | |
| diffusers, PyTorch | 모델 실행 라이브러리 (uv 가상환경) | |
rembg isnet-anime | 캐릭터 배경 제거 | 약 170MB |
셋업 스크립트는 가상환경을 만들고 MPS가 잡히는지 먼저 확인한 뒤 모델을 받는다.
uv venv --python 3.12 .venv
uv pip install --python .venv/bin/python -r requirements.txt
.venv/bin/python -c "import torch; assert torch.backends.mps.is_available(); print('MPS OK')"
모델 다운로드는 Hugging Face 토큰(HF_TOKEN)을 넣어야 빨랐다. 없으면 한참 느려진다. 여유 공간은 12GB 정도 잡으면 된다. 라이선스도 확인했다. 블로그에 광고가 붙으니 상업 이용이 되는 모델만 골랐다. Animagine XL 4.0은 CreativeML Open RAIL++-M, IP-Adapter는 Apache-2.0이다.
🧩 또 다른 토큰 문제: 프롬프트는 77토큰에서 잘린다
토큰을 아끼려고 로컬로 왔는데, 로컬 모델에도 토큰 제한이 있었다. SDXL이 프롬프트를 읽는 CLIP은 77토큰까지만 읽고 나머지는 버린다.
실제로 두 번 당했다.
- 품질 태그(
masterpiece, high score, ...)를 프롬프트 맨 뒤에 붙였더니 잘려 나가서 얼굴이 하얗게 뭉개졌다. - 남자 캐릭터 프롬프트가 93토큰이었다. 끝에 있던
white background가 잘려서 흰 배경 대신 한옥이 그려졌다.
그래서 생성 스크립트에서 품질 태그를 맨 앞에 고정했다.
# CLIP은 77토큰까지만 읽는다. 품질 태그를 앞에 둬야 잘리지 않는다.
QUALITY = "masterpiece, high score, great score, absurdres"
STYLE = "webtoon, cel shading, clean lineart, flat color"

prompt = f"{QUALITY}, {a.prompt}, {STYLE}"
중요한 태그일수록 앞에 쓴다.
1boy, solo, white background를 맨 앞에, 캐릭터 설명은 60토큰 안쪽으로.
실행 로그에 truncated because CLIP can only handle sequences up to 77 tokens가 찍히면 잘린 부분부터 본다. 맨 뒤 그림체 태그가 조금 잘리는 정도는 괜찮았다. 문장보다 1girl, solo, black hair, red round glasses 같은 태그 나열을 더 잘 따른다는 것도 이 모델의 특징이다.
덤으로 Claude 쪽 토큰도 줄었다. 태그 한 줄은 문장으로 장면을 설명하는 것보다 훨씬 짧다.
⚡ 장당 108초를 59초로: 속도 실험
느린 건 감수하기로 했지만, 처음 속도는 감수하기 어려웠다. 896×1152, 28단계 기준 한 장에 108초. 다섯 장면에 후보 4장씩이면 20장, 40분이다.
빠르게 만드는 방법을 네 가지 시험했다.
빠른 건 Lightning과 TCD였다. Lightning은 4단계까지 줄이면 12초다. 그런데 둘 다 그림이 바래고 뭉개졌다. Animagine 특유의 선명한 선이 사라지면 빨라도 쓸 수가 없다.
남은 건 DeepCache였다. 별도 모델 없이, 이웃한 단계끼리 U-Net 깊은 층 계산을 재사용하는 라이브러리다. 간격 2에서 59초, 그림체 차이는 눈으로 구분이 안 됐다.
from DeepCache import DeepCacheSDHelper

helper = DeepCacheSDHelper(pipe=pipe)
helper.set_params(cache_interval=2, cache_branch_id=0)
helper.enable()
간격 3은 44초까지 내려가지만 배경에 잡티가 생겼다. 간격 2를 기본값으로 박았다. 포즈를 지정하려고 붙여 본 ControlNet OpenPose는 반대로 158초로 느려졌고, 끌어안기 같은 자세는 끝내 못 따라왔다.
빨라지는 설정은 많다. 그림체를 지키면서 빨라지는 건 DeepCache 간격 2 하나였다.
속도가 반으로 줄자 작업 방식도 바꿨다. 후보를 4장에서 2장으로 줄이고, 먼저 나온 게 괜찮으면 나머지는 멈춘다. 20장·40분이던 작업이 10장·10분이 됐다. 클라우드만큼은 아니어도 기다릴 만한 속도다.
🎲 시드 번호로 고르고, 기록한다
같은 프롬프트라도 시드(처음 노이즈 번호)가 다르면 다른 그림이 나온다. -n 4를 주면 시드를 1씩 올려 4장을 뽑는다.
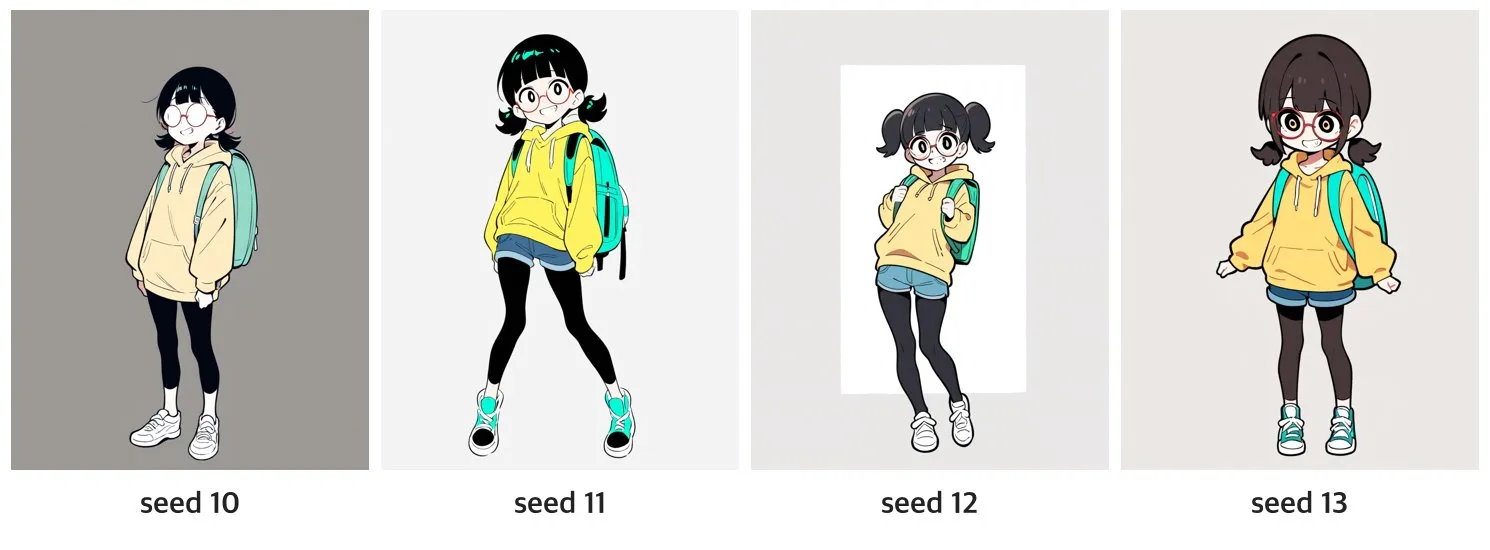
같은 캐릭터 프롬프트로 뽑은 4장이다. 노란 후드, 빨간 안경, 민트 가방은 다 들어갔다. 그런데 머리 묶음, 바지 길이, 안경 크기가 제각각이다. 여기서 프롬프트를 고쳐(단발, 무릎길이 바지) 다시 뽑았고, 고친 프롬프트의 13번 시드를 기준 이미지로 정했다. 위 그림의 13번과는 다른 그림이다.
마음에 든 그림의 시드는 반드시 적어 둔다. 같은 시드와 같은 프롬프트면 같은 그림이 다시 나온다. 파일 이름에 -s13.png처럼 시드를 박아 두면 따로 기록할 필요도 없다.
✂️ 생성 횟수를 줄인 진짜 비결: 재료를 합성한다
로컬이라 토큰은 안 들지만 시간은 든다. 한 장에 1분이니 덜 뽑을수록 이득이다.
Animagine은 한 장에 한 사람을 그릴 때 가장 안정적이었다. 세 사람이 한 식탁에 앉은 장면을 통째로 뽑으면 얼굴이 섞이고 손이 엉켰다. 그래서 장면을 조립했다. 배경 따로, 인물 따로 뽑고, 인물은 배경을 지워 투명 PNG로 만든다. 나머지는 코드가 붙인다.
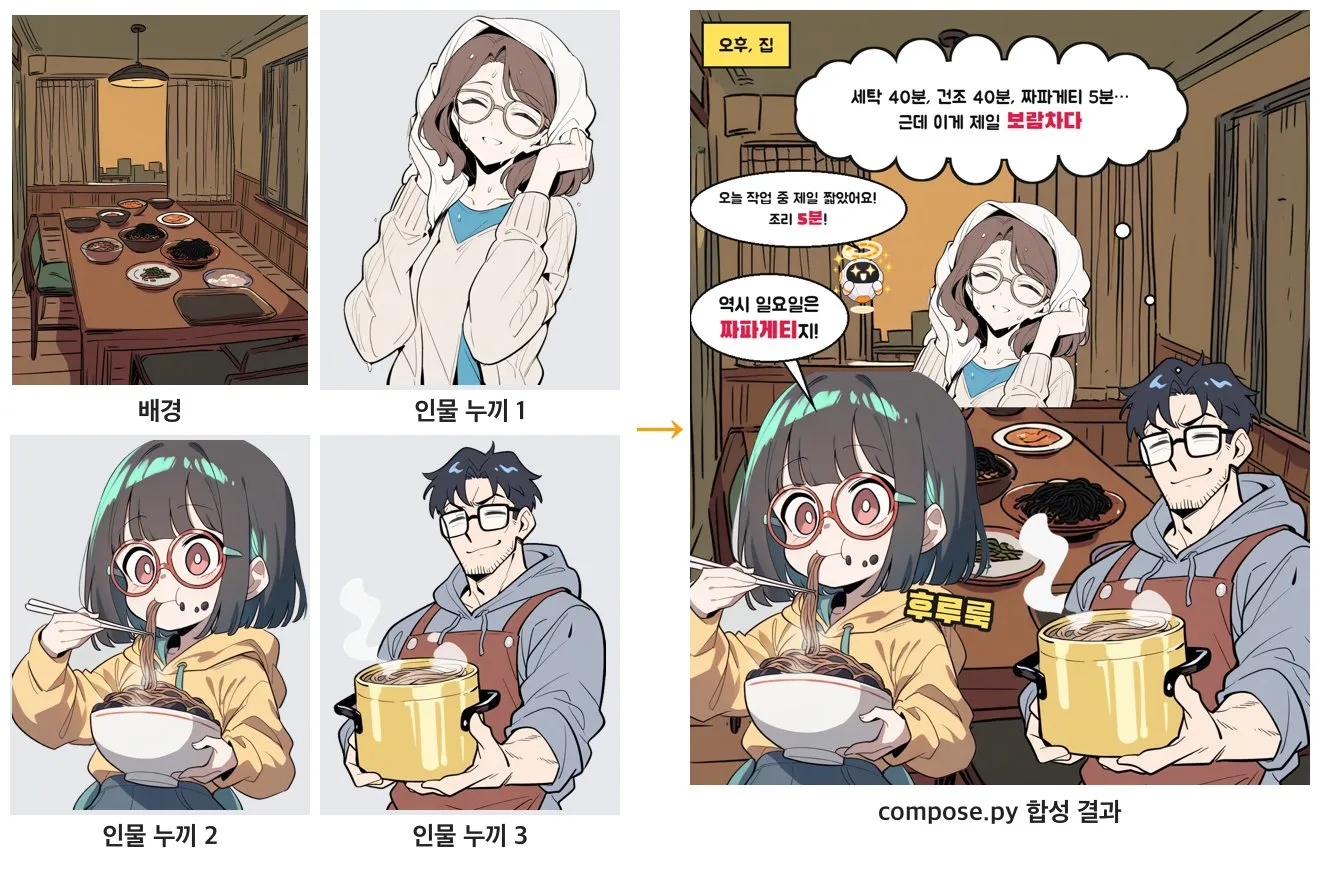
장면 배치는 JSON 한 파일로 적는다. Claude가 쓰는 건 이 정도 텍스트다.
{
  "name": "c5",
  "scene": "out/bg-s300.png",
  "stickers": [
    {
      "src": "assets/person-a.png", "x": 316, "y": 330, "h": 560,
      "behind": [[0, 692], [1080, 692], [1080, 1350], [0, 1350]]
    }
  ],
  "bubbles": [
    { "kind": "speech", "text": "역시 일요일은\n짜파게티지!", "x": 20, "y": 470, "w": 300, "tail": [220, 700] }
  ]
}behind는 이 다각형 안쪽을 그리지 않는다는 뜻이다. 상반신만 뽑은 인물의 잘린 아랫부분을 식탁 뒤로 숨기는 용도다.
compose.py가 이걸 읽어 1080×1350 PNG를 만든다. 한 장에 1초가 안 걸린다. 글자를 고치고 싶으면 JSON만 바꿔 다시 돌리면 된다. 그림을 다시 뽑을 일이 없다.
이 방식이 아낀 건 생각보다 컸다.
- 자주 나오는 캐릭터는 표정 7종을 투명 PNG로 한 번 잘라 두고 계속 붙였다. 한 번도 다시 생성하지 않았다.
- 휴대폰 채팅 화면, 표, 진행률 화면은 코드로 그렸다. 모델이 그린 글자는 어차피 깨진다.
- 손이 물건을 쥐는 장면은 피했다. 휴대폰이 필요하면 손은 빼고 화면만 합성했다. 손가락 검수에 쓰던 재생성이 확 줄었다.
생성은 비싸고 합성은 공짜다. 다시 뽑아야 할 이유를 코드 쪽으로 옮길수록 생성 횟수가 줄었다.
붙인 티가 너무 나는 장면은 합성본 전체를 Animagine으로 30% 강도로 한 번 더 그리고, 애니 전용 업스케일러(Real-ESRGAN anime_6B)로 선을 정리했다. 이때 얼굴은 보호 상자로 막아 둬야 한다. 다시 그리면 표정이 바뀐다.
😵 3일 쓰고 한계에 부딪힌 지점
약 270장을 뽑고 나니 같은 문제가 반복됐다.
| 문제 | 실제로 겪은 일 |
|---|---|
| 여러 인물 | 한 장면에 두 명 이상이면 얼굴이 섞임. 결국 매번 따로 뽑아 합성 |
| 합성 티 | 상반신만 붙이면 공중에 뜬 것처럼 보임. 식탁 뒤로 숨기는 다각형을 매번 지정 |
| 손 | 젓가락, 휴대폰을 쥔 손은 3장 이상 뽑아 확대 검수 |
| 일관성 | 같은 캐릭터인데 뽑을 때마다 머리 길이, 머리색 하이라이트가 달라짐 |
| 그림체 | 애니풍이 강해서 금테 안경이 은테로, 아이가 실제보다 커 보이는 후보가 자주 나옴 |
마지막 두 줄이 결정적이었다. 같은 캐릭터는 몇 번을 그려도 같은 사람으로 보여야 하는데, 붙여서 만드는 방식으로는 장수가 쌓일수록 어긋났다. 합성을 위한 규칙(보호 상자, 숨김 다각형, 누끼 검수)이 늘어나는 것도 부담이었다.
생성 횟수는 줄였지만, 그 대가로 합성 규칙이 계속 늘었다. 한 장면에 여러 명을 그릴 수 있는 모델이 필요했다.
그래서 11월 10일에 생성 모델을 FLUX.2 klein 4B로 바꿨다. 로컬에서 돌리고 Claude는 글자만 쓴다는 원칙은 그대로다. 같은 장면을 두 모델로 다시 그려 비교한 결과는 다음 글에서 정리했다.
🧮 실제로 토큰을 얼마나 아꼈나
Claude Code는 세션마다 메시지별 토큰 사용량을 기록으로 남긴다. Animagine을 쓴 3일 동안 생성을 돌린 세션 7개를 집계했다.
| 항목 | 값 |
|---|---|
| 로컬에서 생성한 이미지 | 약 270장 (폴더에 남은 파일 268장, 중간에 멈춘 것까지 치면 실행 명령 기준 294장) |
| 이미지 생성에 쓴 토큰 | 0 |
| Claude 출력 토큰 | 약 96만 (프롬프트, 레이아웃 JSON, 코드, 대화) |
| Claude가 결과 이미지를 열어 본 횟수 | 433회 |
같은 270장을 클라우드에서 뽑았다면 얼마였을까. ChatGPT 구독은 토큰이 아니라 사용 한도로 계산돼서 화면에서 숫자를 볼 수 없다. 그래서 OpenAI 이미지 API 단가로 환산해 봤다. 공개된 계산기 기준으로 세로 이미지 한 장은 중간 품질 약 1,600토큰, 고품질 약 6,200토큰이다. 270장이면 약 43만~168만 토큰, 100만 토큰당 30달러로 치면 13~50달러쯤 된다. 구형 모델 수치를 쓴 대략의 환산이라 참고만 하자.
의외였던 건 마지막 줄이다. 생성은 공짜였지만 결과를 검수하려고 Claude가 이미지를 열어 볼 때마다 입력 토큰이 들었다. 이미지 한 장을 읽는 데 드는 토큰은 해상도와 모델에 따라 다르지만 대략 천 토큰 단위다. 433번이면 이것만으로 수십만 토큰이다.
로컬로 돌린다고 토큰이 0이 되지는 않는다. 사라지는 건 생성 비용이고, 검수에 드는 토큰은 남는다.
검수 토큰을 줄이려면 후보 여러 장을 작은 썸네일 한 장으로 묶어 한 번에 보여 주는 게 낫다. 열 장을 따로 열면 열 번 값을 낸다.
✅ 로컬 이미지 생성 전에 확인할 6가지
- 속도냐 토큰이냐. 다시 뽑는 일이 적거나 유료 계정이 있으면 클라우드가 낫다. 반복이 많을 때 로컬이 이득이다.
- 도커 쓰지 않기. Mac에서는 MPS를 쓰려면 직접 설치해야 한다.
- 라이선스 먼저. 광고가 붙는 블로그라면 모델 카드에서 상업 이용 여부를 확인한다.
- 프롬프트 77토큰. 중요한 태그를 앞에 두고, 로그의
truncated경고를 본다. - 속도 설정은 그림체로 판단. 빠른 LoRA보다 DeepCache 간격 2가 그림체를 지켰다.
- 다시 뽑을 일을 코드로. 글자, 화면, 반복 캐릭터는 생성하지 말고 합성한다. 시드는 파일 이름에 남긴다.
관련 글
로컬 이미지 생성 모델 교체기, Animagine에서 FLUX.2 klein으로
M1 Pro 맥북의 로컬 이미지 생성 모델을 FLUX.2 klein 4B로 바꿨다. 장당 59초가 136초로 느려졌는데 뽑는 장수는 줄었다. 셋업, 문장형 프롬프트, 부분 수정, 속도 측정 기록.
Orca Chat UI 사용법, Claude Code·Codex를 채팅으로 쓰기
Orca에서 Claude Code와 Codex를 터미널 대신 채팅 화면으로 쓰는 법. 설정 위치, 구조화 채팅과 터미널 채팅의 차이, 에이전트 간 대화 넘기기, 권한 기본값 함정까지 정리했다.
DocumentDB 예약 인스턴스 대신 Savings Plans로 20% 절감
DocumentDB 콘솔에는 예약 인스턴스 구매 메뉴가 없다. r6g를 r8g로 바꾸고 7일 뒤 데이터베이스 절감형 플랜을 사서 인스턴스 2대 비용을 약 20% 줄인 과정과 구매 전 확인할 조건을 정리했다.