Aurora PostgreSQL 15→16 Blue/Green 업그레이드
Aurora PostgreSQL 15를 Blue/Green으로 16에 올리며 세 번 실패한 원인(논리 복제 워커 수)과 해결, 사전 점검부터 그린 검증·스위치오버·사후 정리까지 콘솔 화면 기준으로 정리했다.
Aurora PostgreSQL 15의 표준 지원은 2028년 2월 29일에 끝난다. 아직 1년 넘게 남았지만 그 뒤로는 Extended Support 요금이 vCPU 시간 단위로 붙고, 13이 올해 2월에 그 문턱을 넘는 걸 옆에서 본 입장에선 “나중에”가 생각보다 빨리 온다. 16은 Aurora에 올라온 지 2년 반이 지나 LTS까지 나왔으니 지금이 가장 부담 없는 시점이다.
이 글은 쓰기 중단을 1분 안쪽으로 끊기 위해 Blue/Green 배포로 15.17 클러스터를 16.15에 올린 기록이다. 콘솔에서 보면 “배포 생성, 스위치오버” 두 단계처럼 보이지만, 실제로는 배포 생성이 세 번 연속 실패하고서야 왜 실패하는지 알았다. 데이터베이스 7개짜리 db.r6g.large 클러스터 기준이고, RDS 콘솔 기준으로 쓰되 DB 안에서 확인할 건 SQL로 적는다. 클러스터 이름은 prod-apg15로 가정한다.
전체 흐름은 다섯 덩어리다.
- 논리 복제가 옮기지 못하는 것들을 블루에서 먼저 치운다.
- 데이터베이스 수를 세고, 그에 맞춰 블루와 16용 파라미터 그룹에 논리 복제 값을 넣고 재부팅한다.
- 배포를 만들어 그린이 블루를 따라오게 한다.
- 그린에서 ANALYZE, 확장 업데이트, 쿼리 검증을 끝낸다.
- 트래픽이 낮은 시간에 스위치오버하고 떨어져 나간 것들을 다시 붙인다.
🧭 In-place냐 Blue/Green이냐
Aurora에서 메이저 버전을 올리는 방법은 크게 셋이다. 스냅샷 복원 후 업그레이드는 다운타임이 가장 길어 사실상 제외하면 둘이 남는다.
| 구분 | In-place 업그레이드 | Blue/Green 배포 |
|---|---|---|
| 원리 | 클러스터 자체를 pg_upgrade로 변환 | 클론을 16으로 올리고 논리 복제로 동기화 후 스위치오버 |
| 쓰기 중단 | 변환 동안 Writer 불가, Reader는 순차 재시작 | 스위치오버 1분 내외 |
| 사전 조건 | 복제 슬롯 없음, reg* 타입 없음 | 논리 복제 켜고 재부팅, 모든 테이블에 PK |
| 진행 중 제약 | 없음 | 블루에서 DDL·대용량 객체·MV refresh 금지 |
| 검증 | 별도 클론으로 리허설 | 그린 자체가 운영 데이터를 따라오는 검증 환경 |
| 롤백 | 자동 생성된 preupgrade 스냅샷으로 복원 | 블루 클러스터가 -old1로 남음 |
| 적합한 경우 | 새벽 점검 시간 30분을 확보할 수 있는 서비스 | 쓰기 중단을 몇 분도 못 참는 서비스 |
Blue/Green을 고른 이유는 하나다. Writer가 멈추는 시간을 리허설로 재 봤더니 서비스가 허용하는 점검 창을 넘겼다.
대신 치러야 하는 대가는 분명하다. 그린이 떠 있는 동안 블루에서 CREATE TABLE 하나만 실행돼도 복제가 Replication degraded 상태로 떨어지고, 배포를 지우고 처음부터 다시 만들어야 한다. 배포 주기가 잦은 서비스라면 배포 생성부터 스위치오버까지의 며칠을 “스키마 변경 동결” 기간으로 잡고 시작해야 한다.
In-place는 단순하고 실패 지점이 적다. Blue/Green은 중단은 짧지만 “그린이 살아 있는 며칠 동안 운영 DB의 스키마를 건드리지 않는다”는 약속을 팀 전체가 지켜야 한다.
15에서 반드시 16을 거칠 필요는 없다. 15.17 블루의 엔진 버전 목록에는 16.x와 함께 17.9~17.11, 18.3~18.6이 바로 떴다. 17로 갈 거면 16으로 전환한 뒤 다시 올리는 것보다(전환 순단이 두 번) 처음부터 17을 타깃으로 배포를 만드는 게 낫고, 17 패밀리 파라미터 그룹을 똑같이 준비해야 한다. 이번엔 호환성 검증 범위를 좁히려고 16으로 갔다.
🔍 사전 점검: 논리 복제가 못 옮기는 것들
Blue/Green은 그린 클러스터를 만들 때 Aurora 스토리지를 클론해서 pg_upgrade를 돌리고, 그다음부터는 PostgreSQL 논리 복제로 블루의 변경을 따라간다. 그래서 점검도 두 종류다. pg_upgrade가 거부하는 것과 논리 복제가 거부하는 것.
pg_upgrade 쪽은 In-place와 같다. 아래 셋이 있으면 그린 생성이 실패한다.
regtype과regclass를 제외한 reg 계열 타입 컬럼- 커밋되지 않은 prepared transaction
DROP DATABASE도중 끊겨 invalid로 남은 데이터베이스(pg_database.datconnlimit가 -2)
PostGIS를 쓴다면 raster·topology·tiger_geocoder·address_standardizer 계열 확장은 배포 생성 전에 15에서 제공하는 최신 버전으로 먼저 올려 둔다. 다른 확장은 그린에서 올리면 되지만 이 묶음은 순서가 반대다.
논리 복제 쪽이 Blue/Green 고유의 함정이고, 아래 다섯 항목이다.
🔑 PK 없는 테이블
논리 복제는 PK(또는 replica identity)가 없는 테이블의 UPDATE와 DELETE를 옮기지 못한다.
SELECT n.nspname, c.relname
FROM pg_class c
JOIN pg_namespace n ON n.oid = c.relnamespace
WHERE c.relkind = 'r'
  AND n.nspname NOT IN ('pg_catalog', 'information_schema')
  AND NOT EXISTS (
    SELECT 1 FROM pg_index i
    WHERE i.indrelid = c.oid AND i.indisprimary
  );
결과는 0건이어야 한다. 한 건이라도 나오면 그냥 두면 안 되는데, 이유가 그린이 못 받아서가 아니다. 블루(운영) 쪽에서 UPDATE와 DELETE가 즉시 실패한다.
ERROR: cannot update table "t" because it does not have a replica identity and publishes updatesINSERT만 하는 테이블이면 실제로는 안 걸리지만, 배포 기간 내내 UPDATE가 한 번도 없다고 장담할 수 없다면 손을 대야 한다. 데이터가 작은 테이블이면 선택지는 둘이다.
-- 1안: PK를 붙인다. 유일한 NOT NULL 컬럼이 있으면 그걸로, 없으면 대리키를 추가
SELECT col1, col2, count(*) FROM t GROUP BY 1, 2 HAVING count(*) > 1;  -- 중복 확인, 0건이어야 함
ALTER TABLE t ADD PRIMARY KEY (col1, col2);
ALTER TABLE t ADD COLUMN id bigint GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY;

-- 2안: 스키마·앱을 건드리지 않고 행 전체로 식별
ALTER TABLE t REPLICA IDENTITY FULL;
1안이 깔끔하지만, 앱이 컬럼 목록 없이 위치 기반으로 INSERT하고 있으면 컬럼이 하나 늘어난 순간 깨진다. 그 쿼리를 확신할 수 없으면 2안이 안전하다. 2안은 행 전체를 비교하며 복제하므로 쓰기가 잦은 큰 테이블에는 쓰지 않지만, 작은 테이블에선 비용이 의미 없고 스위치오버 뒤 REPLICA IDENTITY DEFAULT로 되돌리면 된다.
어느 쪽이든 배포 생성 전에 끝낸다. ALTER TABLE은 DDL이라 그린이 뜬 뒤에 실행하면 복제가 degraded로 떨어진다. 끝낸 뒤 위 조회를 다시 돌려 0건을 확인한다.
📦 대용량 객체와 unlogged 테이블
SELECT count(*) AS large_objects FROM pg_largeobject_metadata;

SELECT n.nspname, c.relname
FROM pg_class c
JOIN pg_namespace n ON n.oid = c.relnamespace
WHERE c.relpersistence = 'u';
첫 번째는 large_objects가 0, 두 번째는 0건이어야 한다.
대용량 객체(LO)는 기존 것도 새로 만든 것도 그린으로 가지 않고, 배포 중에 LO를 만들거나 바꾸면 복제가 degraded로 떨어진다. 0이 아니면 LO를 bytea 컬럼이나 S3로 옮기고 나서 배포를 만들거나, 그게 당장 어려우면 이 클러스터는 In-place로 가는 게 안전하다.
unlogged 테이블은 블루 클러스터 파라미터 rds.logically_replicate_unlogged_tables를 1로 켜야 복제되고, 배포 생성 뒤에 이 값을 바꾸면 안 된다. 캐시처럼 날아가도 되는 데이터인지 먼저 보고, 지켜야 하는 데이터면 ALTER TABLE ... SET LOGGED로 바꾸는 쪽이 파라미터를 켜는 것보다 단순하다.
🧩 확장: pg_partman·pglogical·pg_cron
세 확장은 배포와 충돌한다. pg_partman은 파티션을 만들 때 CREATE TABLE을 실행하고, pglogical과 pgactive는 블루를 다른 논리 복제의 한쪽 끝으로 만들며, pg_cron은 그린에서 superuser 워커로 돌면서 읽기 전용 설정을 우회해 복제 충돌을 낸다.
확장은 데이터베이스 단위로 설치되므로 조회는 데이터베이스마다 돌리고, 백그라운드 워커로 뜨는 것들은 클러스터 파라미터도 같이 본다.
SELECT extname, extversion
FROM pg_extension
WHERE extname IN ('pg_partman', 'pglogical', 'pgactive', 'pg_cron');

SHOW shared_preload_libraries;
extname | extversion
------------+------------
pg_partman | 5.1.0
pg_cron | 1.6
shared_preload_libraries
---------------------------------------
pg_stat_statements,pg_partman_bgw,pg_cron조회가 0건이고 preload 목록에 pg_partman_bgw·pglogical·pgactive가 없으면 그냥 넘어간다. 위 예시처럼 나오면 확장별로 처리가 다르다.
pg_partman: 배포 기간 동안 파티션 생성이 돌지 않게 막는다. 블루 클러스터 파라미터 그룹의 preload 목록에서 pg_partman_bgw를 빼고(다음 섹션의 재부팅에 같이 태운다), pg_cron으로 run_maintenance()를 걸어 뒀다면 그 job도 내린다. 그리고 배포 생성 직전에 run_maintenance()를 한 번 손으로 돌려 스위치오버 예정일까지 쓸 파티션을 미리 만들어 둔다. 파티션 주기가 하루인데 배포를 일주일 띄울 예정이면 premake 값을 그만큼 올리고 돌린다.
pglogical·pgactive: 다음 항목의 외부 복제와 같은 처리다. node와 subscription을 먼저 정리하고 DROP EXTENSION한 뒤 preload 목록에서도 뺀다. 스위치오버 뒤 새 클러스터에서 다시 설치한다.
pg_cron: 블루에서는 그대로 둬도 된다. 막아야 할 곳은 그린이다. 그린은 16용 파라미터 그룹을 쓰므로 16 클러스터 그룹의 preload 목록에 pg_cron을 넣지 않은 채로 배포를 만든다. 대신 스위치오버 뒤에 pg_cron을 다시 넣고 Writer를 한 번 재부팅해야 하므로, 그 시간을 전환 당일 일정에 넣어 둔다. 블루의 job 목록은 SELECT jobid, schedule, command FROM cron.job;으로 뽑아 두면 전환 뒤 맞춰 보기 쉽다.
🔗 외부 논리 복제
블루 클러스터가 이미 다른 논리 복제의 publisher나 subscriber면 안 된다. DMS나 Debezium으로 CDC를 붙여 놓았다면 그 슬롯과 subscription은 배포 전에 정리하고, 스위치오버 뒤 새 운영 클러스터에서 다시 만든다. DMS 작업은 체크포인트가 그린에서 무효가 되므로 어차피 새로 만들어야 한다.
SELECT slot_name, plugin, active, database FROM pg_replication_slots;
SELECT subname, subenabled FROM pg_subscription;
두 조회 모두 0건이어야 한다. 슬롯이 나오면 plugin과 database 컬럼으로 어떤 소비자가 쓰는지 찾아 그쪽을 먼저 세우고, SELECT pg_drop_replication_slot('slot_name');으로 지운다. 소비자를 세우지 않고 슬롯만 지우면 그 소비자는 다음 연결에서 슬롯이 없다는 에러를 받는다. subscription이 나오면 DROP SUBSCRIPTION으로 정리한다.
⚙️ 앱이 읽기 전용 설정을 덮어쓰는지
스위치오버 동안 그린 Writer는 default_transaction_read_only = on으로 쓰기를 막는다. 앱이 세션 레벨에서 이 값을 off로 덮어쓰고 있으면 스위치오버 도중 그린에 데이터를 써 버릴 수 있고, 롤백이 일어나면 그 데이터는 블루에 없다. ORM 설정이나 커넥션 초기화 쿼리에서 이 파라미터를 건드리는 곳이 없는지 미리 찾아 둔다.
🧩 파라미터 그룹 두 벌 준비
Blue/Green은 파라미터 그룹을 두 벌 요구한다. 블루(15)용에는 논리 복제를 켜야 하고, 그린(16)용은 패밀리가 달라 새로 만들어야 한다. 블루 쪽은 콘솔이 대신 해 주는 자동 경로와 직접 하는 수동 경로가 있다.
무엇보다 먼저 데이터베이스 수를 센다. Aurora PostgreSQL의 Blue/Green은 데이터베이스마다 publication과 subscription을 하나씩 만들어 복제하므로, 논리 복제 워커와 슬롯 수가 이 숫자보다 커야 한다. 이걸 모르고 시작한 게 이번 실패의 전부였다.
SELECT count(*) FROM pg_database WHERE datallowconn AND NOT datistemplate;이 클러스터는 7이 나왔다. 숫자를 기억해 두고 아래로 간다.
⚡ 자동 경로: 콘솔이 블루 그룹을 만들어 준다
배포 생성 화면에 들어갔을 때 블루 파라미터 그룹에 필요한 값이 빠져 있으면 상단에 블루 파라미터 그룹 파라미터 값 수정(재부팅 필요) 라는 빨간 경고가 뜨고, 그 아래 같은 이름의 확인란이 있다.
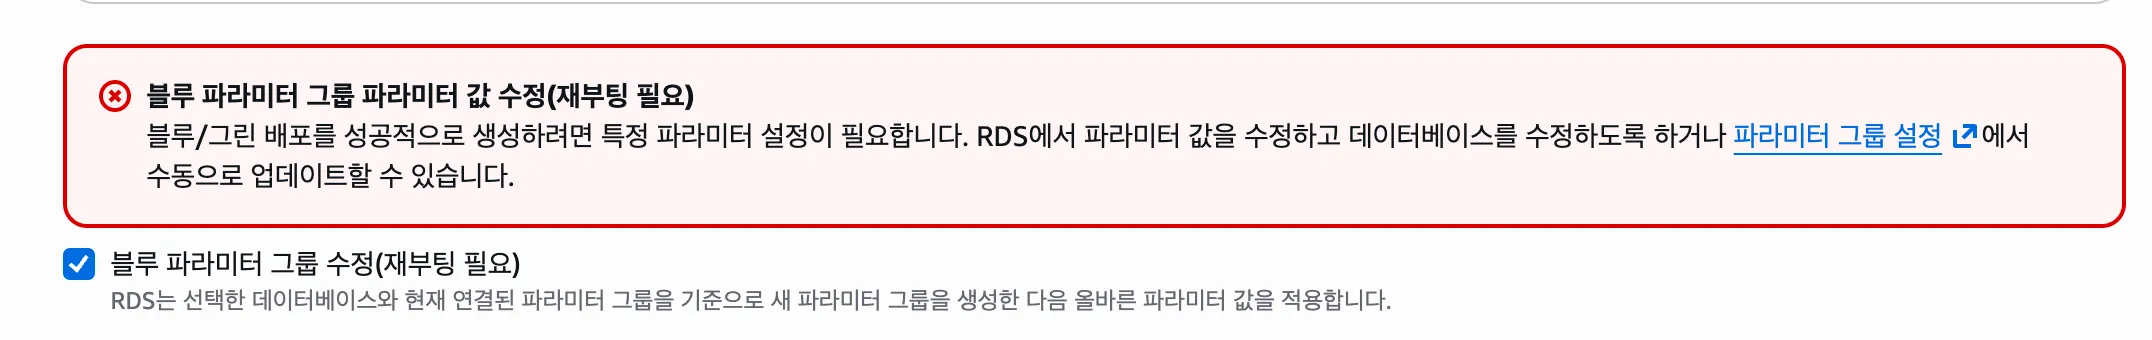
확인란을 체크한 채 다음을 누르면 RDS가 무엇을 할지 보여 주는 대화상자가 먼저 뜬다.
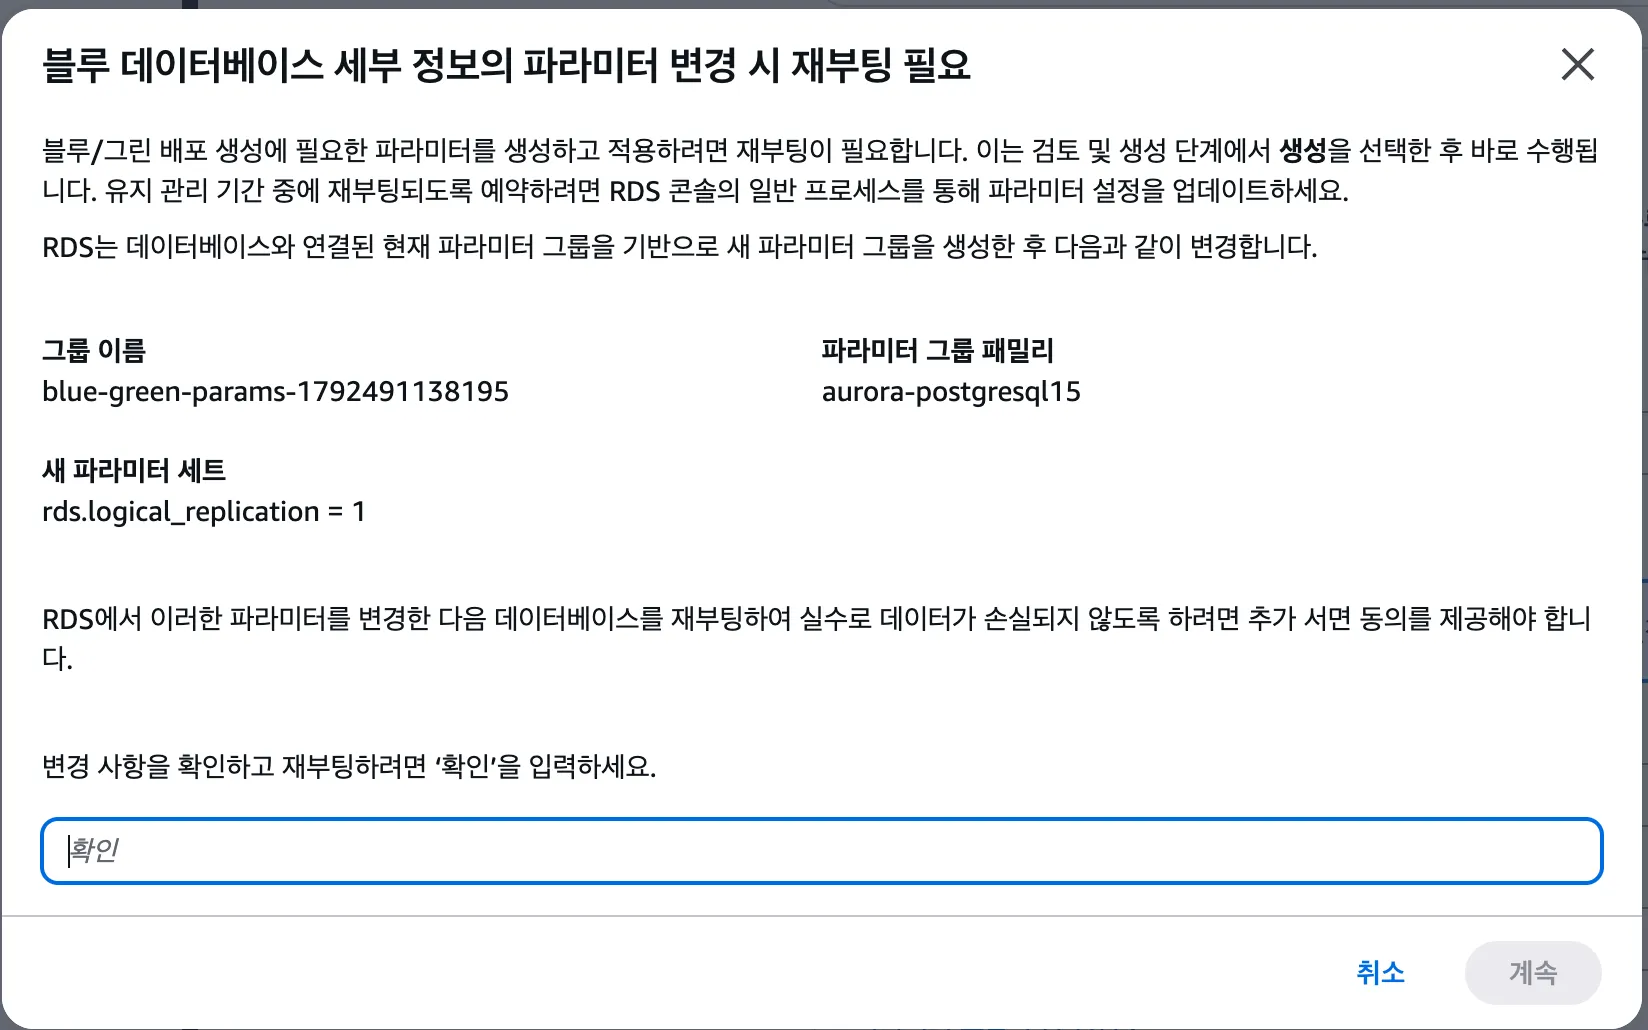
여기에 자동 경로의 실체가 다 적혀 있다.
- 지금 클러스터에 연결된 그룹을 기준으로(기본 그룹이어도 된다)
blue-green-params-<타임스탬프>이름의 15 패밀리 그룹을 새로 만든다. - 거기에
rds.logical_replication = 1하나만 넣어 클러스터에 붙인다. - 재부팅은 2단계 검토 화면에서 생성을 누른 직후 곧바로 실행된다. 유지 관리 기간에 맞춰 미루고 싶으면 수동 경로로 가라고 대화상자가 안내한다.
- 입력란에
확인을 타이핑해야 계속 버튼이 살아난다.
그러니 이 확인란에 체크하는 건 “생성 버튼을 누르는 순간 쓰기 중단을 받아들인다”는 결정이다. 자동 경로를 택하더라도 생성은 쓰기 트래픽이 낮은 시간에 누른다.
생성을 누르면 데이터베이스 목록 위에 “파라미터 그룹을 수정하고 있습니다”라는 파란 진행 배너가 뜨고, 세부 정보 보기를 누르면 RDS가 실제로 밟는 네 단계가 보인다. 파라미터 설정 복사, 파라미터 그룹 수정, 클러스터에 파라미터 그룹 할당, 인스턴스 재부팅 순서다. 재부팅이 끝나야 배포 생성이 시작된다.
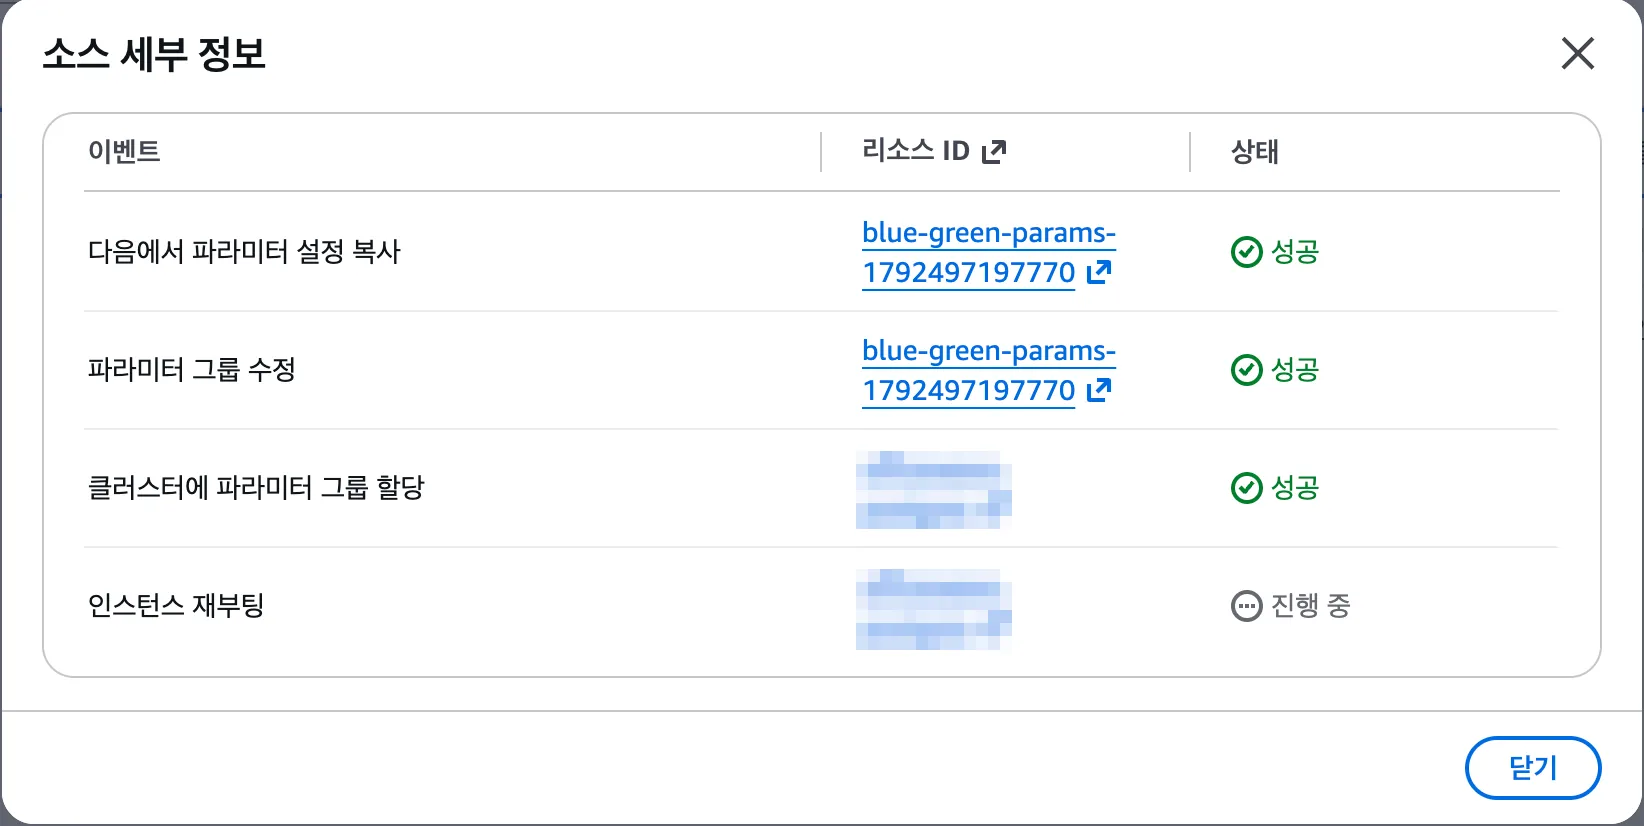
편한 만큼 손이 안 닿는 데가 있고, 첫 번째가 치명적이다.
- 슬롯·워커 수는 기본값 그대로다.
max_logical_replication_workers의 기본값은 4라서 데이터베이스가 넷 이상이면 그린 생성이 실패한다. 이 클러스터는 7개였고, 실제로 이 경로로 만든 배포가 그렇게 실패했다(다음 섹션). 데이터베이스가 셋 이하가 아니면 처음부터 수동 경로로 간다. - Reader는 옛 파라미터로 남는다. 수동 경로의 Reader 재부팅은 자동 경로에서도 똑같이 해야 한다.
- 재부팅 대신 장애 조치로 쓰기 중단을 줄이고 싶거나, Terraform 같은 IaC로 파라미터 그룹을 관리하고 있다면(콘솔이 만든 그룹은 곧바로 드리프트가 된다) 수동 경로로 간다.
🛠 수동 경로: 커스텀 그룹에 직접 값을 넣는다
먼저 블루 클러스터와 인스턴스가 커스텀 파라미터 그룹을 쓰고 있어야 한다. default.aurora-postgresql15 같은 기본 그룹은 값을 편집할 수 없다. 클러스터의 구성 탭에서 DB 클러스터 파라미터 그룹을, 각 인스턴스의 구성 탭에서 파라미터 그룹을 보고, 하나라도 default.로 시작하면 만들어서 붙인다.
만드는 건 파라미터 그룹 메뉴의 생성 버튼에서 패밀리 aurora-postgresql15로 클러스터용 apg15-cluster와 인스턴스용 apg15-instance를 하나씩 만들면 된다. 새 그룹은 기본값과 같은 내용이라 붙인다고 동작이 바뀌진 않는다. 붙이는 건 클러스터 수정 화면에서 클러스터 그룹을, 인스턴스마다 수정 화면에서 인스턴스 그룹을 바꾸고 즉시 적용으로 저장한다. 바꿔 붙이는 것만으로 인스턴스가 pending-reboot 상태가 되지만 어차피 아래에서 재부팅하니 그때 한 번에 처리한다.
이제 apg15-cluster를 열어 편집 버튼을 누르고, 검색창에 이름을 하나씩 넣어 값을 바꾼 뒤 저장한다.
| 파라미터 | 기본값(db.r6g.large) | 넣은 값 | 기준 |
|---|---|---|---|
rds.logical_replication | 0 | 1 | 필수 |
max_logical_replication_workers | 4 | 10 | 데이터베이스 7개 + 테이블 동기화용 여유 3 |
max_worker_processes | 8 | 24 | 워커 10 + autovacuum 3 + parallel 8 = 21 이상 |
max_wal_senders | 10 | 25 | 슬롯 수보다 크게 |
max_replication_slots | 20 | 20 유지 | 데이터베이스 수 + 여유 |
synchronous_commit은 on이어야 한다. 기본값 열을 보면 왜 콘솔 자동 경로가 모자라는지 보인다. max_worker_processes의 기본값은 GREATEST(${DBInstanceVCPU*2},8) 같은 수식이라 2 vCPU 인스턴스에선 8밖에 안 되고, 워커·autovacuum·병렬 워커의 합보다 커야 한다는 AWS 문서 기준(이 경우 21)에 한참 못 미친다. 고정값 대신 GREATEST(${DBInstanceVCPU*2},24)처럼 수식으로 넣으면 나중에 인스턴스를 키울 때 따라간다. 이 값들은 상한이라 복제를 안 쓸 때는 실제로 쓰이지 않는다.
같은 값을 16용 클러스터 그룹에도 똑같이 넣는다. 그린은 16 그룹으로 뜨고 거기서 subscription 워커가 돈다. 모두 정적 파라미터라 저장 직후 Writer 인스턴스의 구성 탭에서 파라미터 그룹 상태가 pending-reboot로 바뀐다. 그 상태에서 Writer를 선택하고 작업 메뉴의 재부팅을 실행한다. 장애 조치가 아니라 일반 재부팅이면 된다.
재부팅이 끝나면 구성 탭의 파라미터 그룹 상태가 동기화 중(in-sync)으로 돌아오는지 보고, SQL로도 값이 들어갔는지 확인한다. 이 클러스터는 값을 넣기 전까지 재부팅할 때마다 max_wal_senders를 RDS가 자동 보정했다는 이벤트가 찍혔는데, 25로 올린 뒤로는 사라졌다.
SHOW max_logical_replication_workers;  -- 10
SHOW max_worker_processes;             -- 24
SHOW max_wal_senders;                  -- 25
Aurora PostgreSQL 15.2 이상은 Writer를 재부팅해도 Reader가 같이 재부팅되지 않는다. 읽기 트래픽은 살아 있고 쓰기만 Writer가 다시 뜨는 동안 끊긴다. 대신 Reader들은 옛 파라미터로 계속 도니까, Writer가 올라온 뒤 Reader도 하나씩 재부팅해 전부 in-sync로 맞춘다. 배포 중 장애 조치가 일어나 옛 파라미터의 Reader가 Writer로 승격되면 논리 복제가 그 자리에서 끊기기 때문이다.
쓰기 중단을 더 줄이고 싶으면 순서를 바꿔 장애 조치를 쓸 수 있다. Reader를 먼저 재부팅해 in-sync로 만들고, 클러스터를 선택해 작업 메뉴의 장애 조치로 그 Reader를 승격시킨다. 쓰기 중단이 재부팅 복구 시간 대신 장애 조치 시간(보통 30초 안팎)으로 줄고, 옛 Writer는 Reader로 내려오며 재시작되므로 파라미터가 같이 적용된다. 승격 뒤 옛 Writer의 구성 탭에서 in-sync를 확인하고, 아니면 그것도 재부팅한다. Reader의 인스턴스 클래스가 Writer보다 작거나 Reader가 없는 단일 인스턴스 클러스터면 이 방법은 쓰지 않는다.
이 재부팅(또는 장애 조치)이 Blue/Green 방식에서 스위치오버 전에 겪는 유일한 쓰기 중단이다. 끝난 뒤 모든 인스턴스의 구성 탭에서 파라미터 그룹 상태가 동기화 중이어야 하고, Writer가 동기화되지 않았으면 배포 생성 자체가 거부된다.
🆕 16용 그룹 만들기
그린 쪽은 패밀리 aurora-postgresql16으로 두 개를 새로 만든다. 파라미터 그룹 생성 화면에서 엔진 유형 Aurora PostgreSQL, 패밀리 aurora-postgresql16을 고른 뒤 유형을 DB 클러스터 파라미터 그룹으로 apg16-cluster를, 다시 DB 파라미터 그룹으로 apg16-instance를 만든다. 패밀리가 다르면 콘솔의 복사 기능이 안 되므로 손으로 옮겨야 한다.
옮길 값은 15 그룹 상세 화면에서 소스(Source) 열이 user인 행이다. 기본값은 engine-default로 표시되니 user만 골라 적어 두고, 16 그룹의 편집 화면에서 같은 이름을 검색해 넣는다. 15 그룹을 이번에 새로 만들었다면 user 행은 방금 넣은 논리 복제 값들뿐일 것이다. 그래도 16 그룹은 만들어야 한다. 기본 그룹으로는 배포 생성 화면에서 그린 쪽 그룹을 지정할 수 없기 때문이다.
옮길 때 16에서 사라진 파라미터를 걸러야 한다. force_parallel_mode는 debug_parallel_query로 이름이 바뀌었고, vacuum_defer_cleanup_age와 promote_trigger_file은 삭제됐다. 15 그룹에 이 값이 있으면 16 그룹에 넣는 순간 에러가 난다. 논리 복제 관련 다섯 값은 15 그룹과 똑같이 넣는다. 전환 뒤 논리 복제를 끌지는 사후 정리에서 정한다.
🟢 배포 생성과 그린이 따라오는 과정
📝 생성 화면 채우기
데이터베이스 목록에서 prod-apg15 클러스터를 선택하고 작업 메뉴의 블루/그린 배포 생성을 누르면 설정 화면이 뜬다. 1단계 생성, 2단계 검토 및 확인으로 나뉘고 1단계에서 채울 칸은 넷이다.
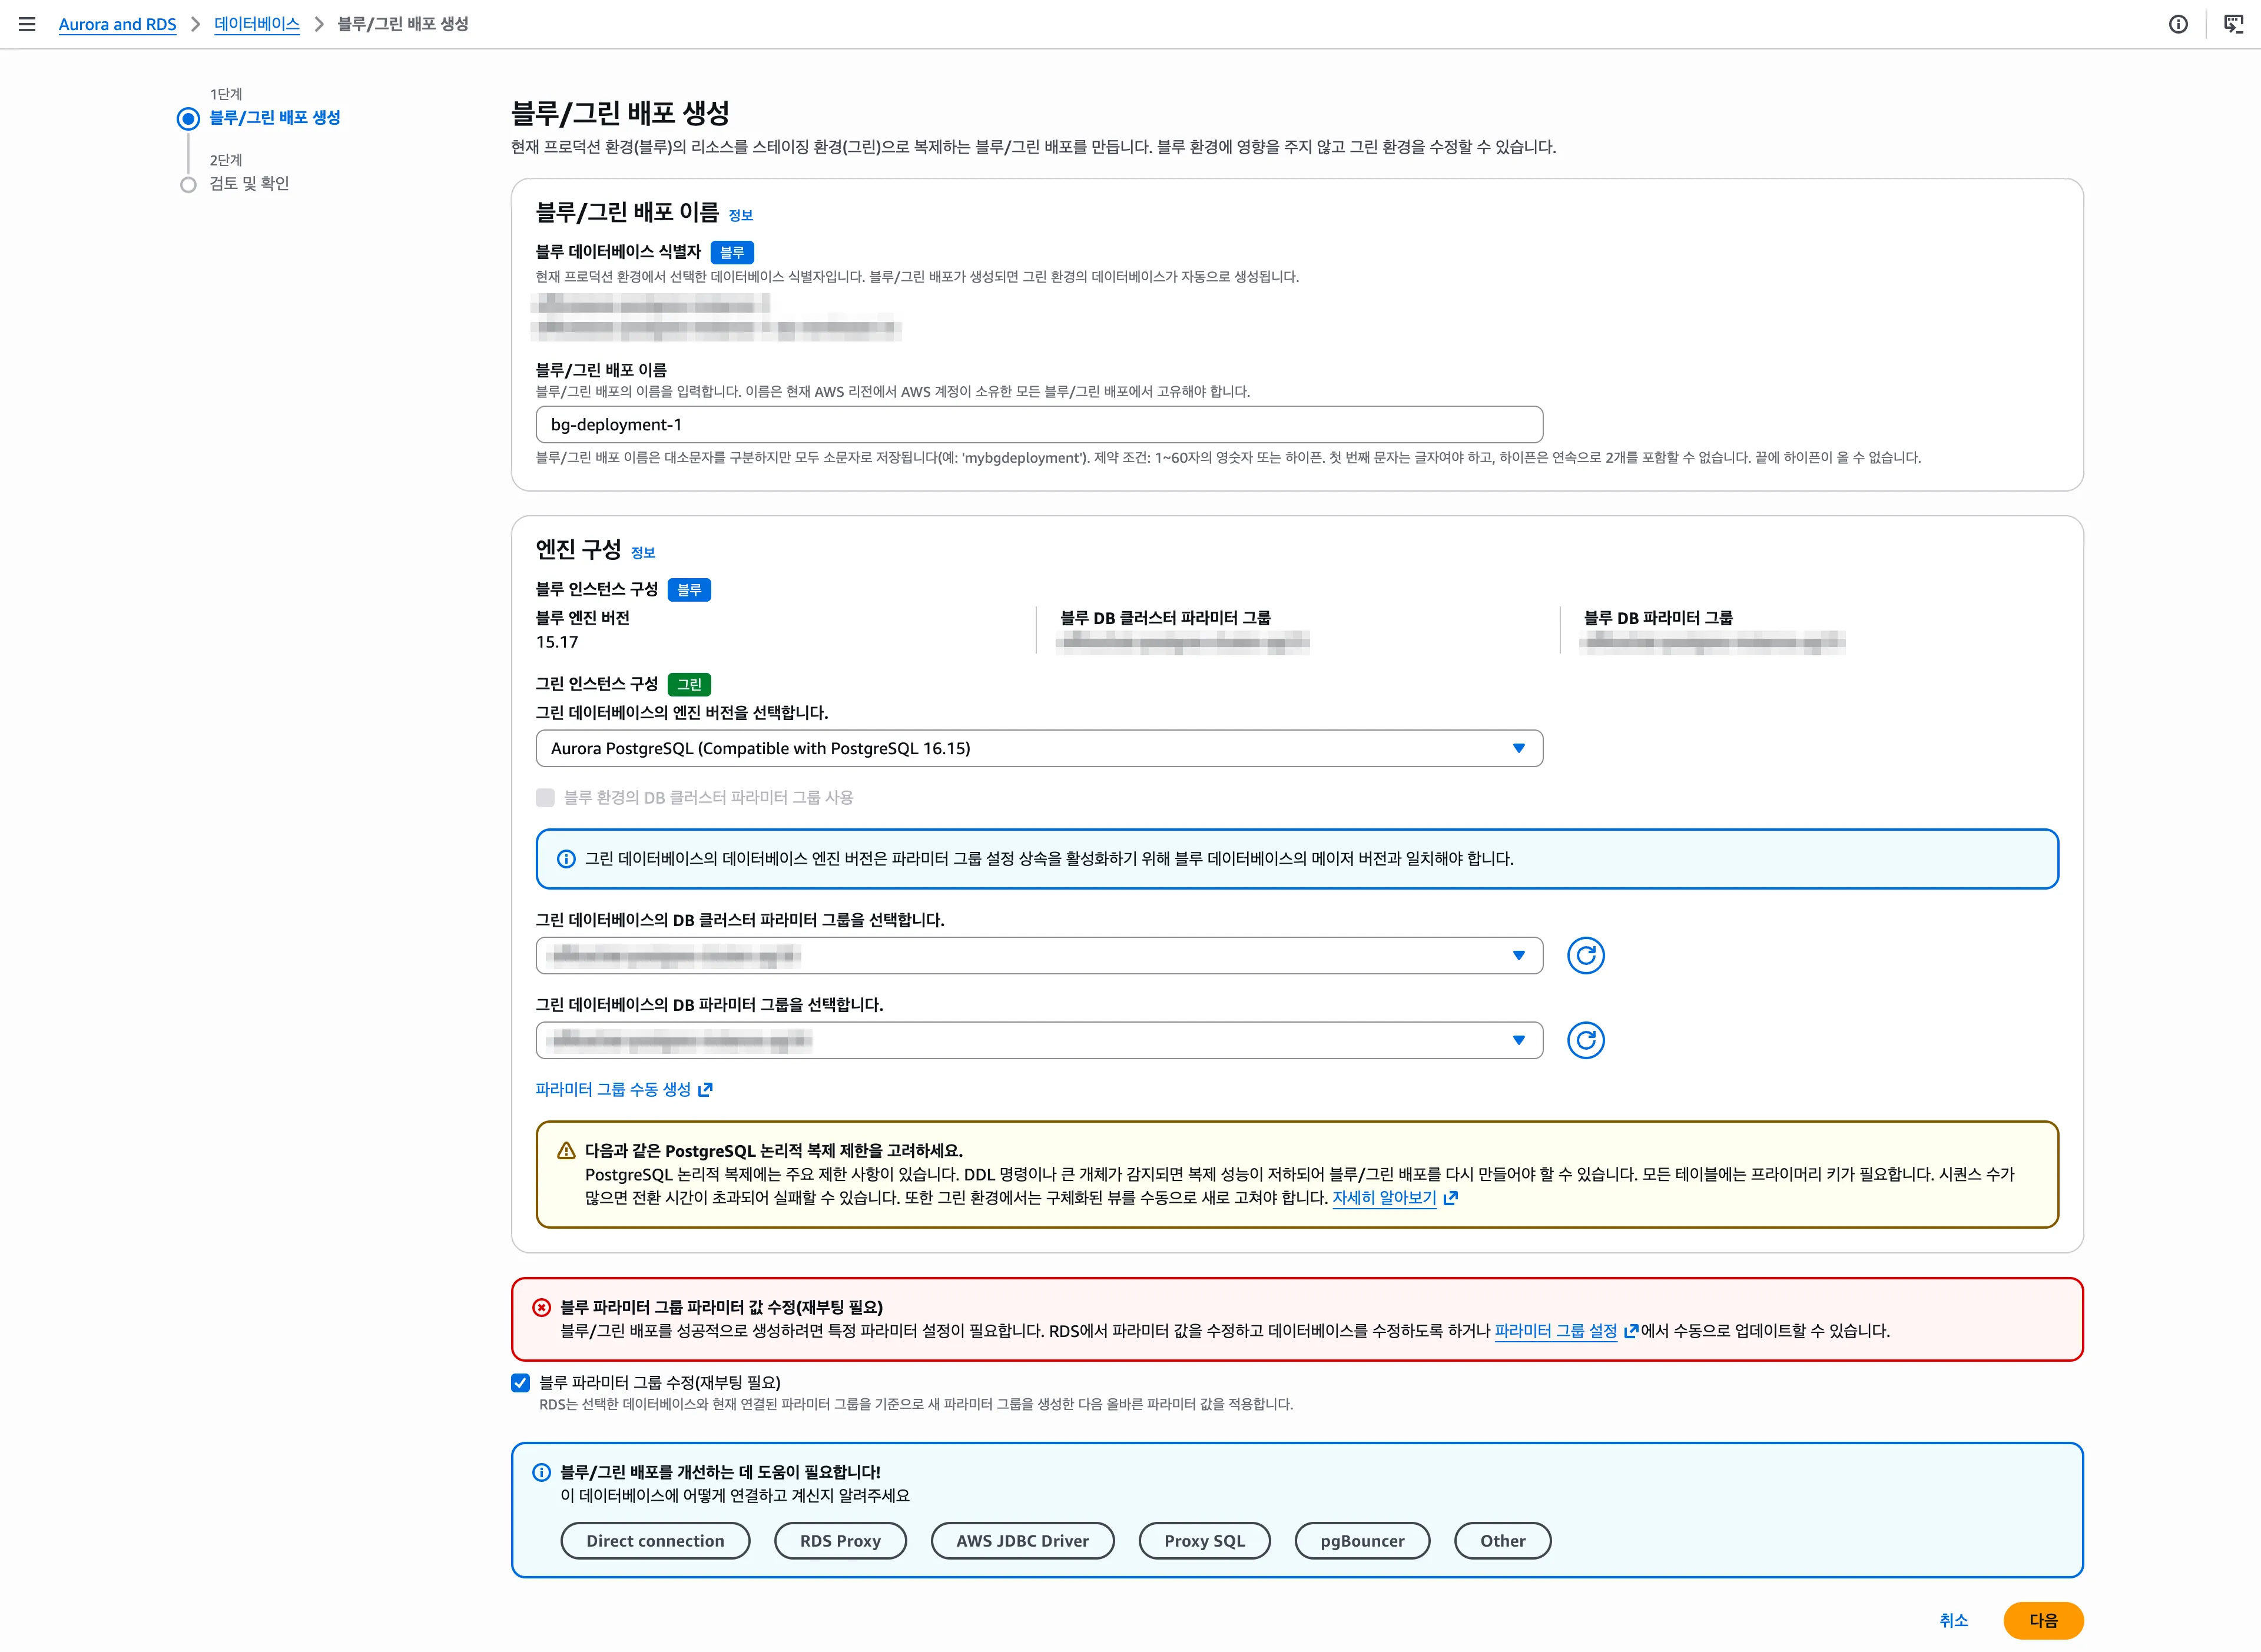
- 블루/그린 배포 식별자: 작업명을 적는다.
- 그린 데이터베이스의 엔진 버전: 드롭다운에 지금 마이너 버전에서 올라갈 수 있는 타깃만 나온다. 15.17 기준으로 16.13~16.15, 17.9 이상, 18.x가 보이고 여기서 16.15를 고른다.
- 그린의 DB 클러스터 파라미터 그룹:
apg16-cluster. - 그린의 DB 파라미터 그룹:
apg16-instance.
엔진 버전 바로 아래 “블루 환경의 DB 클러스터 파라미터 그룹 사용” 확인란은 메이저 버전이 달라지는 순간 회색으로 잠긴다. 15 그룹을 16에 물려줄 수 없다는 뜻이고, 그래서 3번과 4번을 비워 둘 수 없다. 드롭다운에 원하는 16.x가 없으면 현재 마이너 버전이 너무 오래된 것이다. 클러스터 수정에서 15 안의 최신 마이너로 올린 뒤 다시 들어오면 타깃이 나타난다.
그 아래 노란 상자에 논리 복제 제한이 요약돼 있다. 앞 섹션의 점검 항목이 바로 이것이다. 블루 그룹을 수동으로 맞춰 두었다면 빨간 경고는 없어야 한다. 경고와 확인란이 보이면 블루 쪽 값이 안 맞았거나 재부팅이 안 된 것이니, 자동 경로를 쓰기로 했다면 체크하고 진행하고 아니라면 취소하고 돌아가 맞춘다.
화면 맨 아래 다음을 누르면 2단계로 넘어간다. 자동 수정에 체크한 상태라면 그 전에 재부팅 동의 대화상자가 끼어들어 확인을 입력해야 한다. 검토 화면에서 블루와 그린 구성이 의도한 대로인지 한 번 더 보고 생성한다.
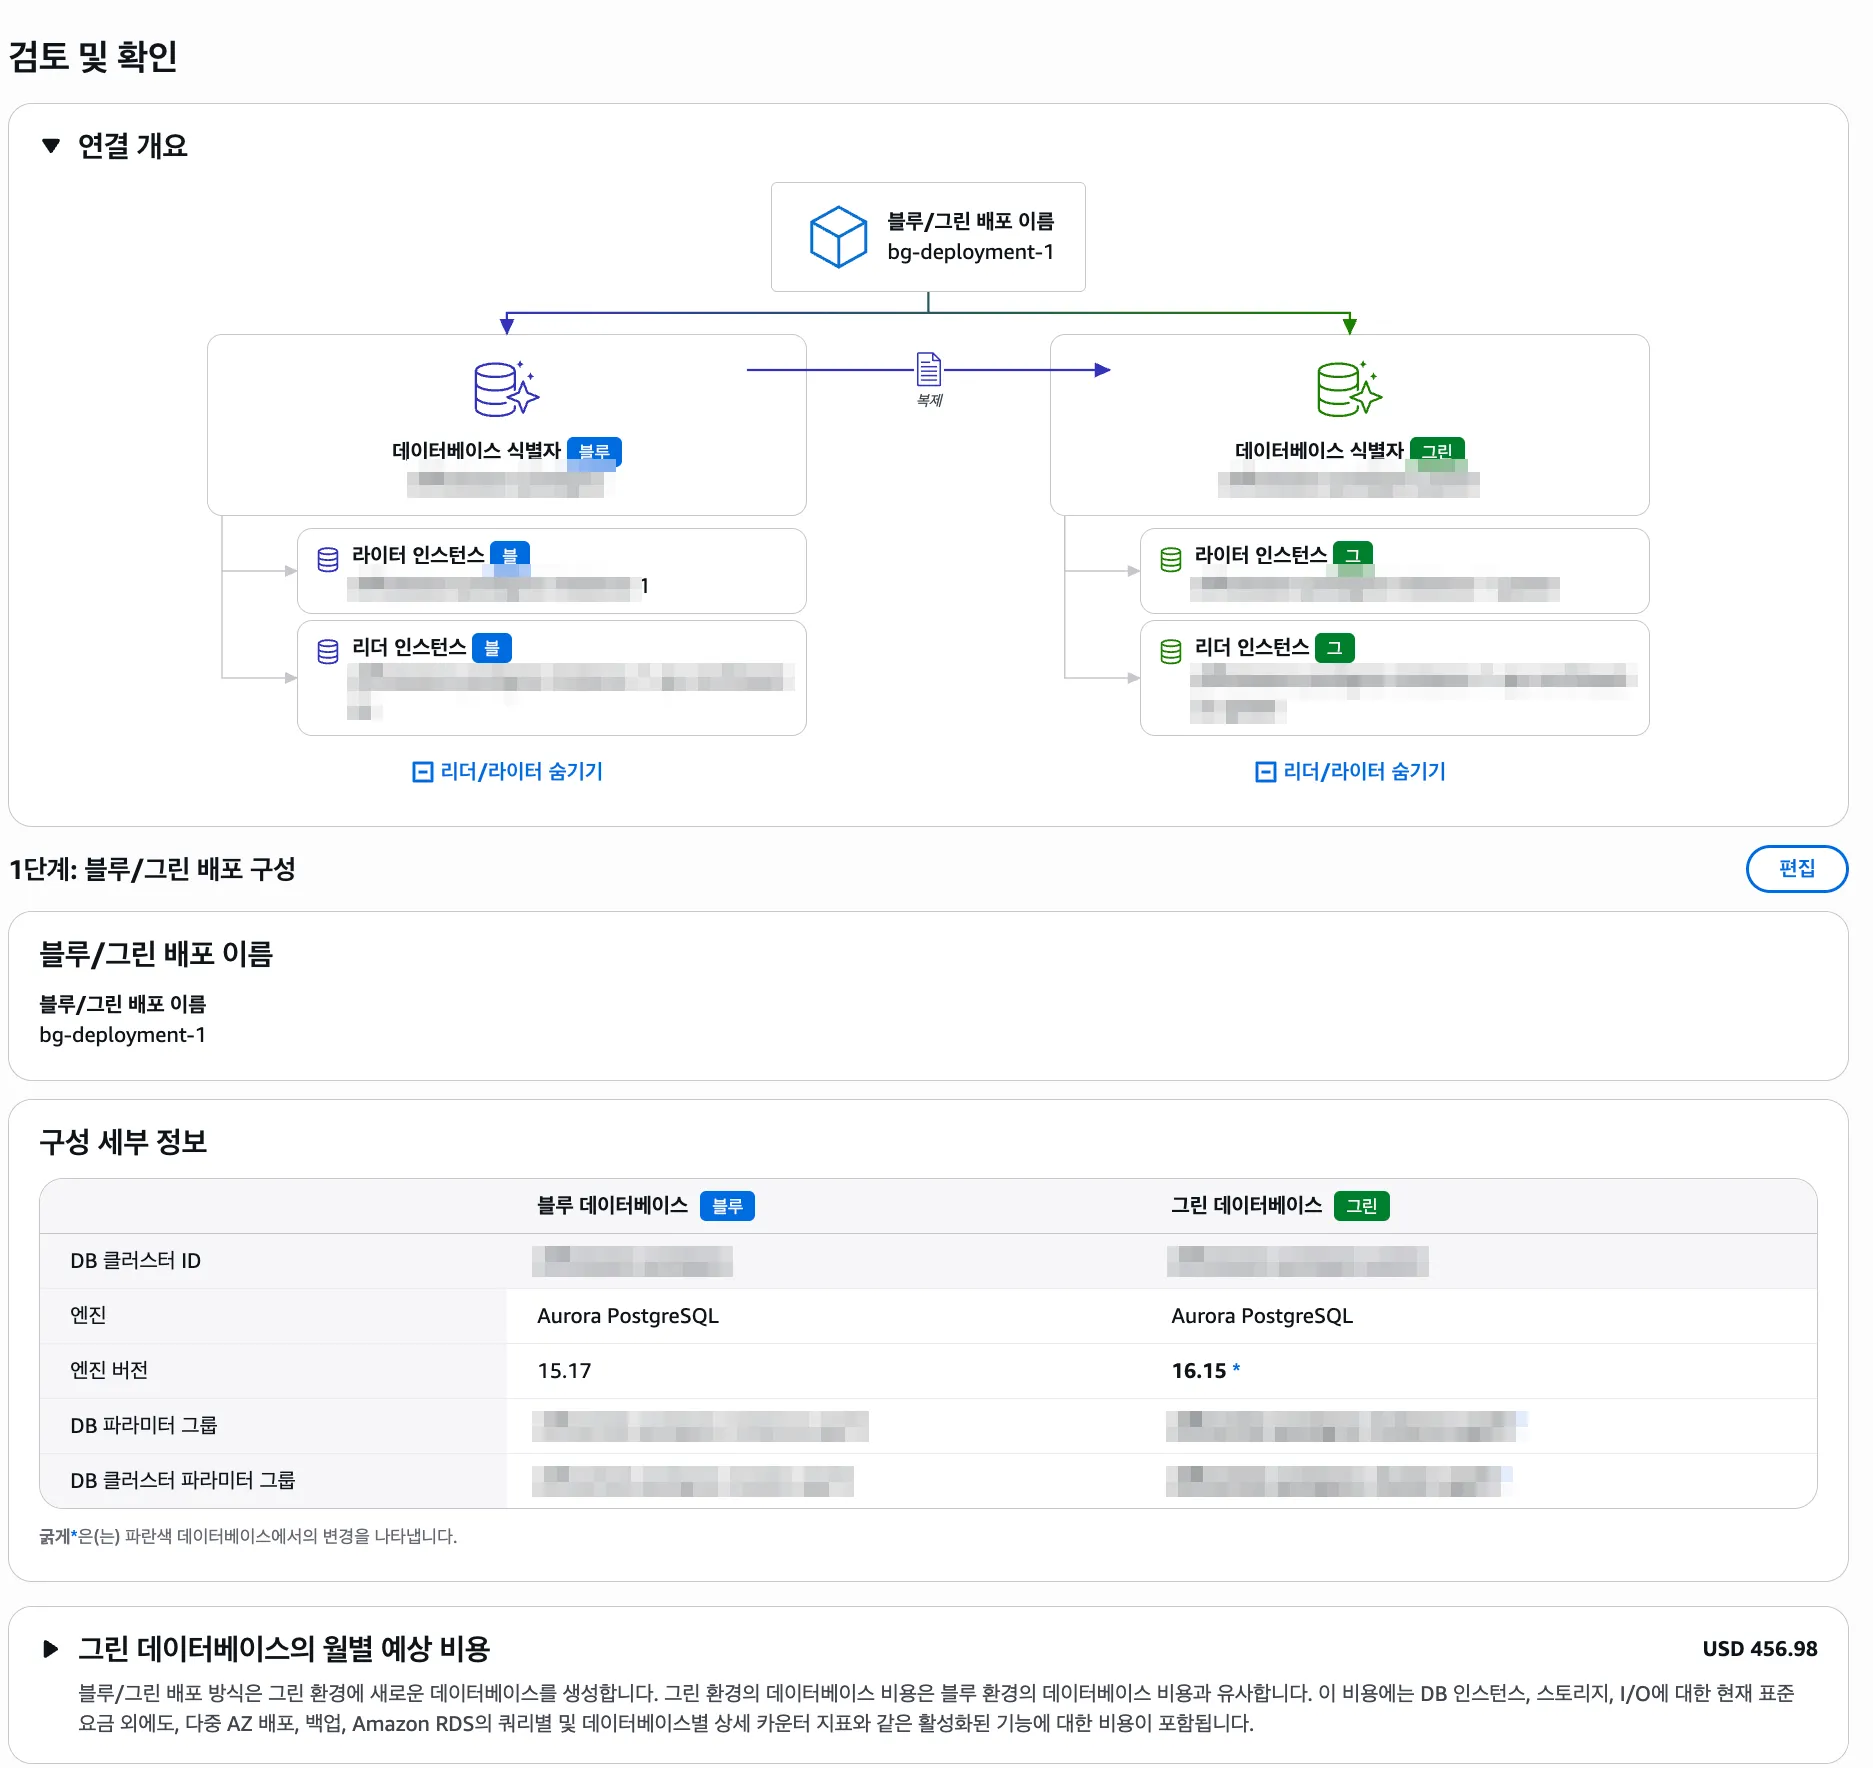
검토 화면은 세 덩어리다. 연결 개요에는 블루의 Writer·Reader가 그린의 어떤 인스턴스로 대응되는지 그림으로 나오고, 구성 세부 정보에는 엔진 버전과 파라미터 그룹이 블루·그린 나란히 놓여 바뀌는 항목만 굵게 표시된다. 맨 아래 그린 데이터베이스의 월별 예상 비용은 블루와 거의 같은 금액이 찍힌다. 그린이 떠 있는 동안은 DB 비용이 두 배라는 뜻이니, 배포를 띄워 놓고 몇 주씩 두지 않는다.
⏳ 상태와 복제 지연 보기
생성 직후 데이터베이스 목록에 배포 행이 블루/그린 배포 역할로 추가되고 상태는 프로비저닝이다. 이 동안 Aurora는 블루 볼륨을 copy-on-write로 클론해 prod-apg15-green-abc123 같은 이름의 클러스터를 만들고, 거기서 pg_upgrade를 돌려 16으로 올린 다음, 블루의 각 데이터베이스에 논리 복제 슬롯을 만들어 변경을 흘려보내기 시작한다. 그린 인스턴스는 결국 블루 토폴로지 그대로 복제되지만 한 번에 뜨지는 않는다.
배포 행을 클릭하면 블루/그린 상태 탭에 복제 다이어그램과 그린 환경 상태 세 단계가 보인다. 원본의 읽기 전용 복제본 생성, DB 엔진 버전 업그레이드, 클러스터에 대한 DB 인스턴스 생성 순서로 진행되고, 셋 다 완료가 되면 배포 상태가 사용 가능으로 바뀐다.
❌ 잘못된 구성으로 떨어졌을 때
이 클러스터는 첫 단계에서 세 번 연속 멈췄다. 배포 상태는 잘못된 구성, 그린 클러스터는 호환되지 않는 생성에 인스턴스 0개, 그린 환경 상태의 첫 줄은 FAILED였다.
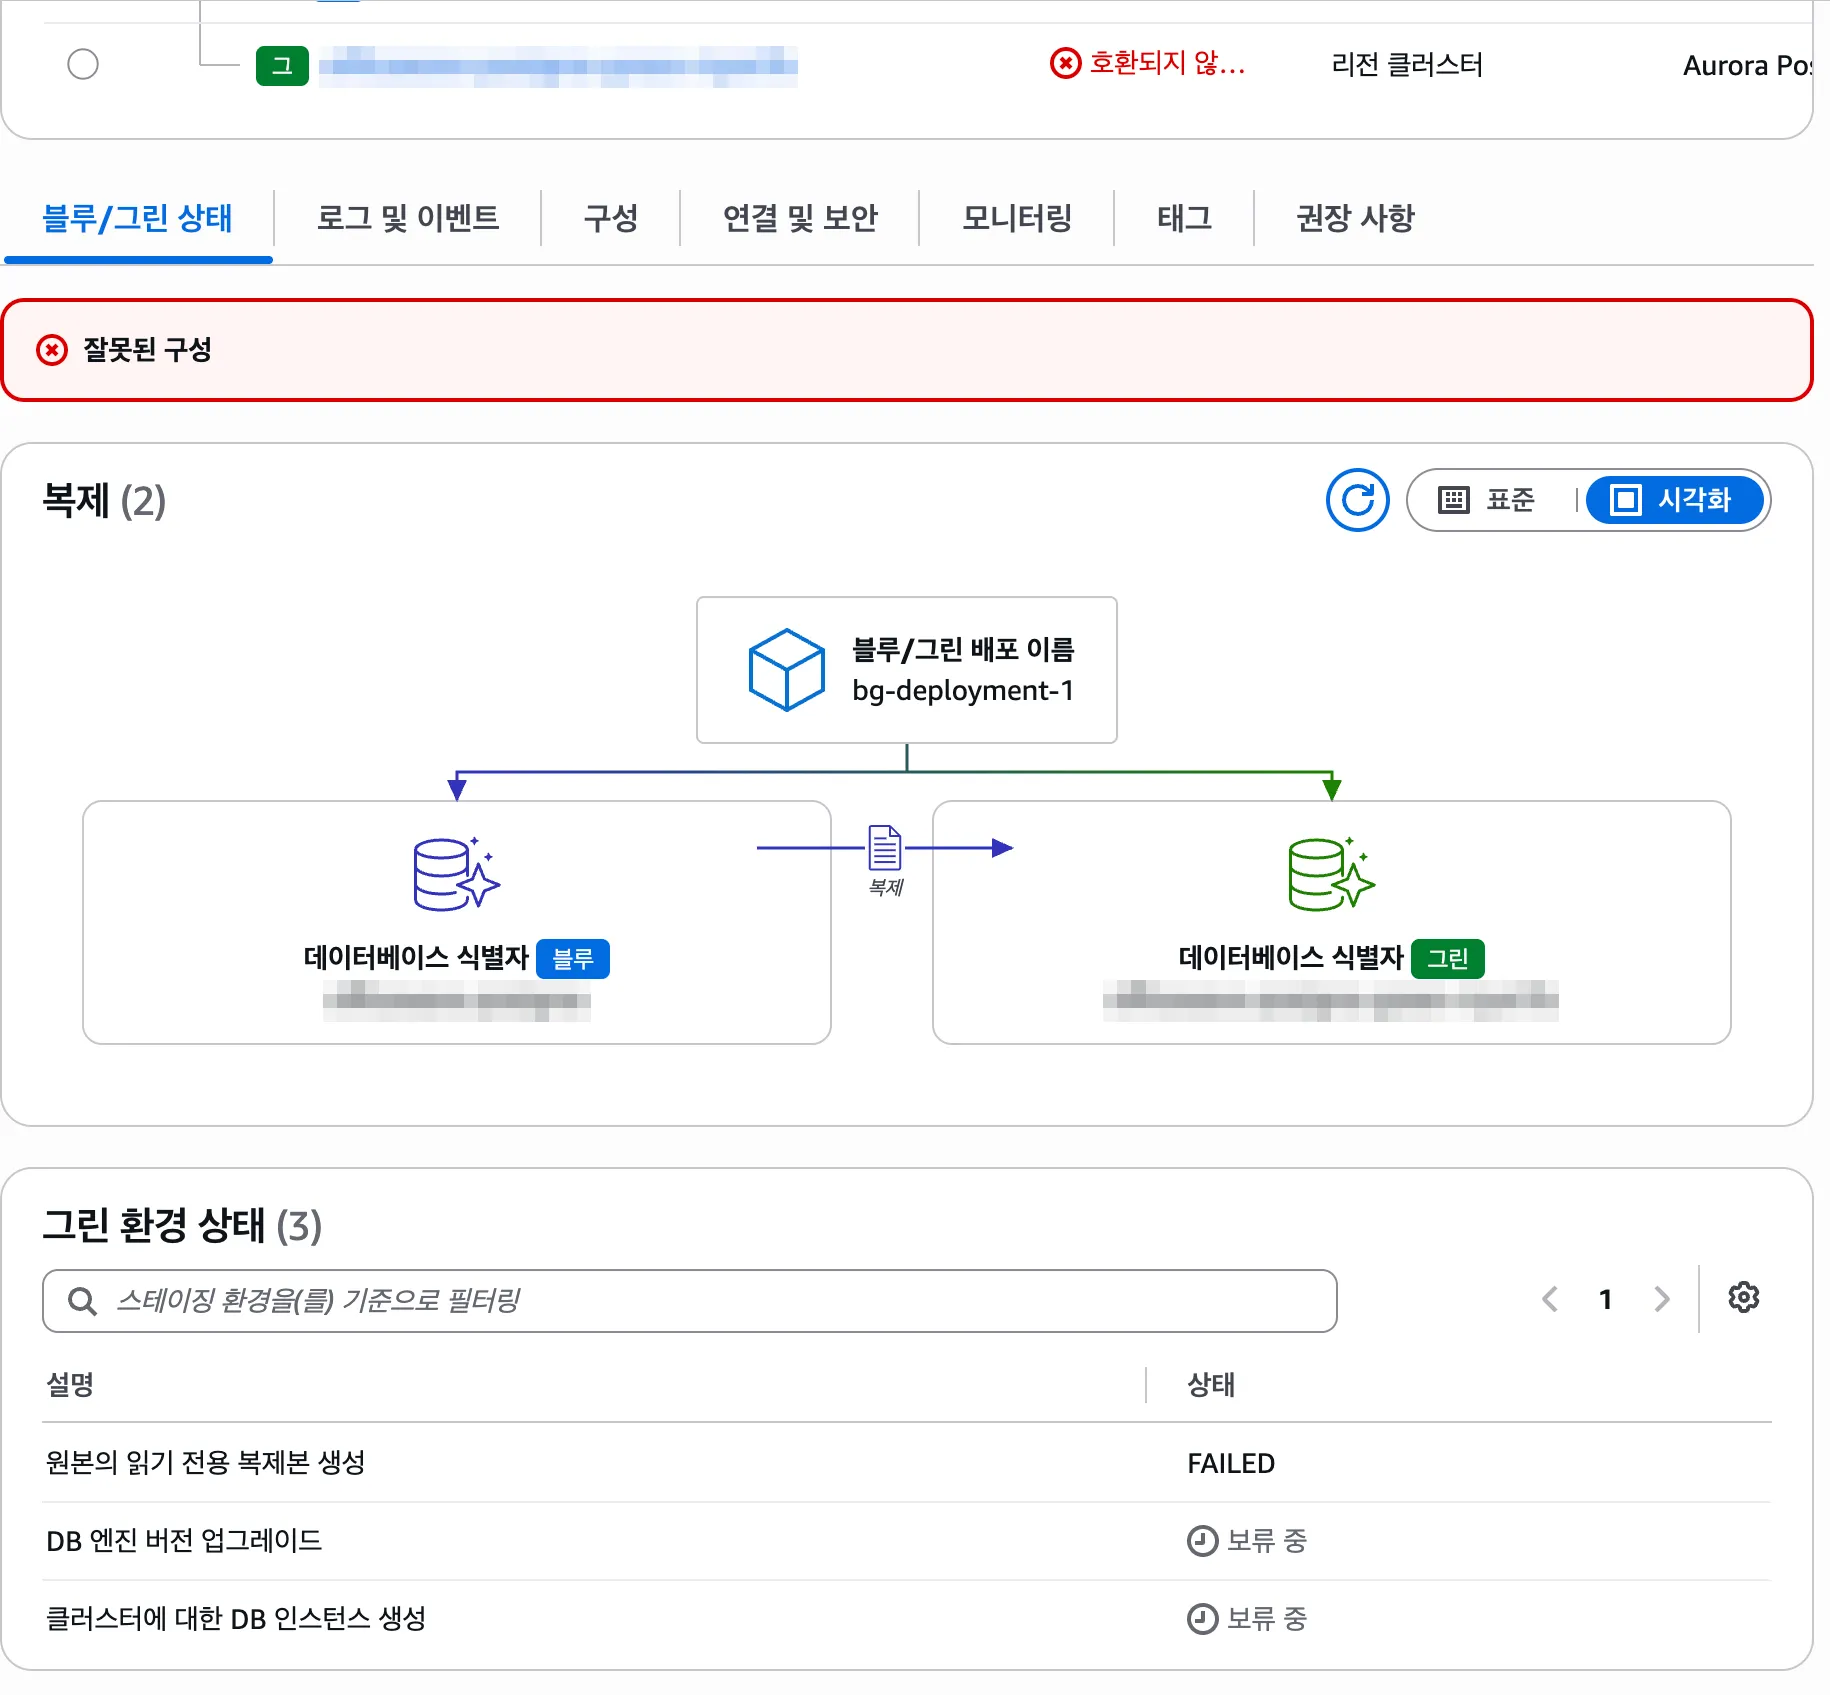
원인은 왼쪽 메뉴의 이벤트에서 블루 클러스터 이름으로 거르면 나온다. 이때 찍힌 메시지가 이것이다.
Creation of blue/green deployment failed due to incompatible parameter(s): max_logical_replication_workers메시지에 파라미터 이름이 그대로 적혀 있는데도 두 시간을 돌아갔다. 콘솔 자동 생성 그룹을 커스텀 그룹으로 되돌려 재부팅하고, 장애 조치로 Writer를 바꿔 보고, 다시 원복해 봤지만 결과는 같았다. 자동 생성 그룹과 커스텀 그룹 둘 다 워커 수가 기본값 4였고 데이터베이스는 7개였으니 당연했다. 교훈은 하나다. 에러 메시지에 나온 파라미터부터 본다.
실패한 배포는 고쳐서 이어 갈 수 없다. 배포와 그린 클러스터를 지우고, 15·16 클러스터 그룹에 앞 섹션의 값을 넣고, Reader와 Writer를 차례로 재부팅해 동기화 중을 확인한 다음 배포를 다시 만든다. 그 외에 잘못된 구성이 나오는 원인은 Writer가 파라미터 그룹과 동기화되지 않았거나(재부팅 누락), pg_upgrade 사전 점검에 걸렸거나(reg 타입, prepared transaction), 확장 제약을 안 지킨 경우다. 어느 쪽이든 이벤트 메시지에 적혀 있다.
✅ 정상 진행과 소요 시간
배포 행의 상태 옆 링크를 누르면 연결 세부 정보 대화상자에 다섯 단계가 나온다. 배포 생성, 그린 DB 생성, 원본의 읽기 전용 복제본 생성, DB 엔진 버전 업그레이드, 클러스터에 대한 DB 인스턴스 생성 순서이고, 위에서부터 차례로 진행 중이 완료로 바뀐다.
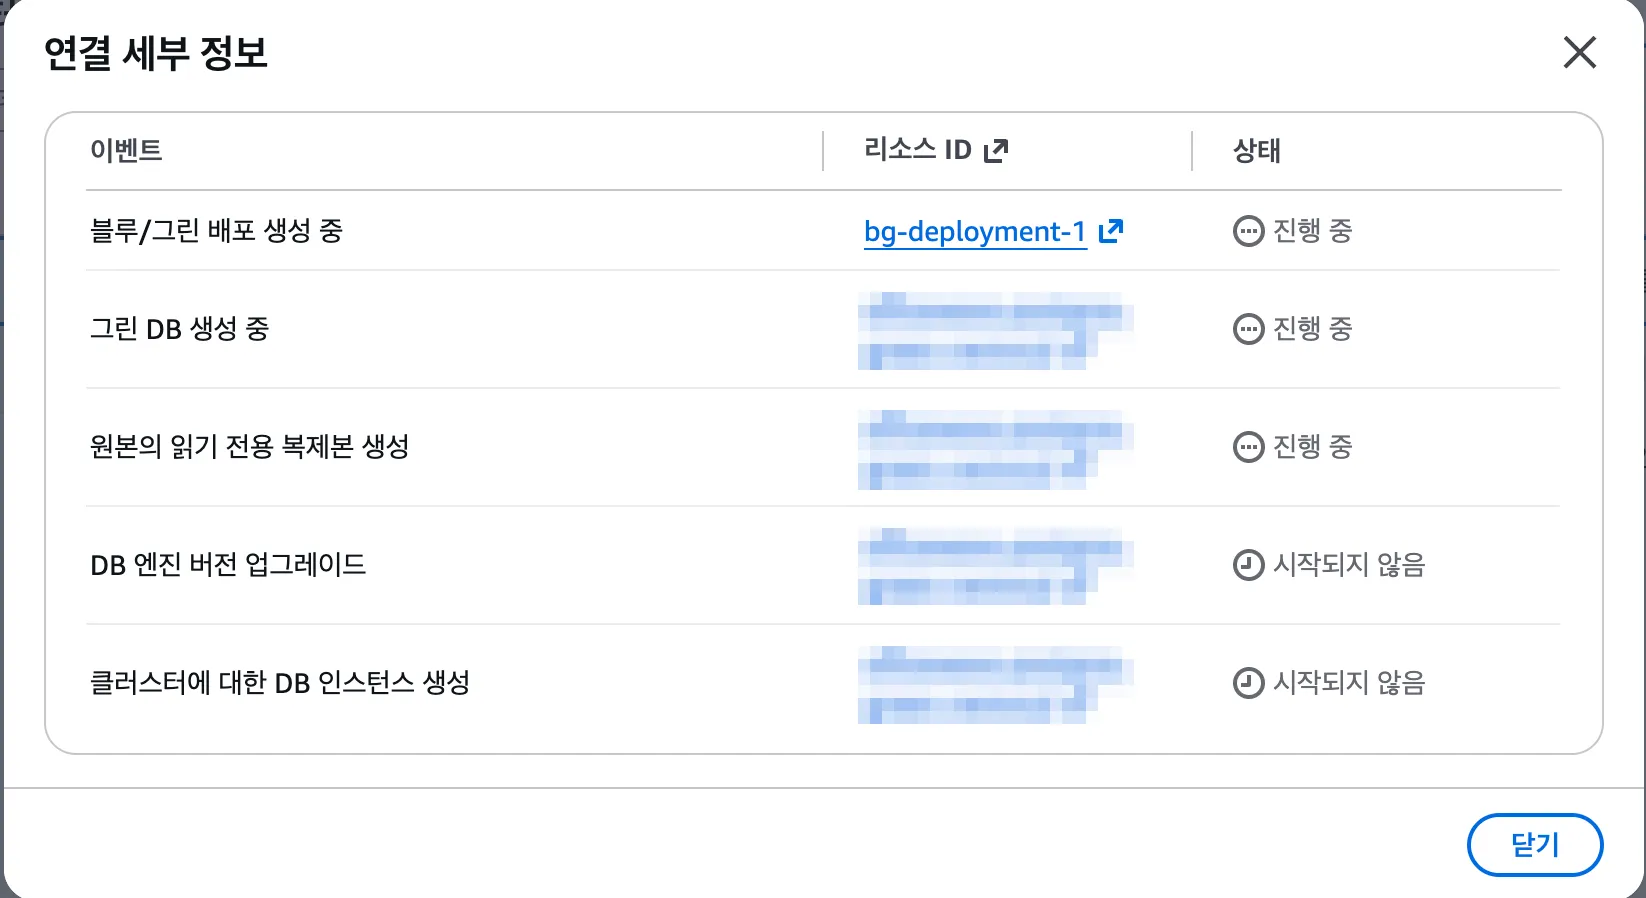
값을 고쳐 다시 만든 배포는 약 40분 만에 끝났다. 이벤트 기준 흐름은 이렇다.
| 경과 | 이벤트 |
|---|---|
| 0분 | 배포 생성, 첫 단계 진행 중 |
| 약 30분 | 그린 클러스터 온라인, 16용 파라미터 그룹 적용 |
| 약 32분 | 그린 메이저 업그레이드 완료(15.17.5 → 16.15.1, 오프라인 504초) |
| 약 33분 | 그린 복제 재개 |
| 약 37분 | 그린 Reader 인스턴스 생성 |
| 약 38분 | Blue/green deployment tasks completed |
업그레이드 오프라인 504초는 그린 쪽 얘기라 운영에는 영향이 없다. 그린 인스턴스는 처음엔 Writer 한 대만 보이고, 엔진 업그레이드가 끝난 뒤 세 번째 단계에서 Reader가 자동으로 붙는다. 손으로 추가하면 안 된다. 데이터 크기보다 DB 오브젝트 수가 시간을 좌우하므로 30분에서 1시간 사이로 잡으면 된다.
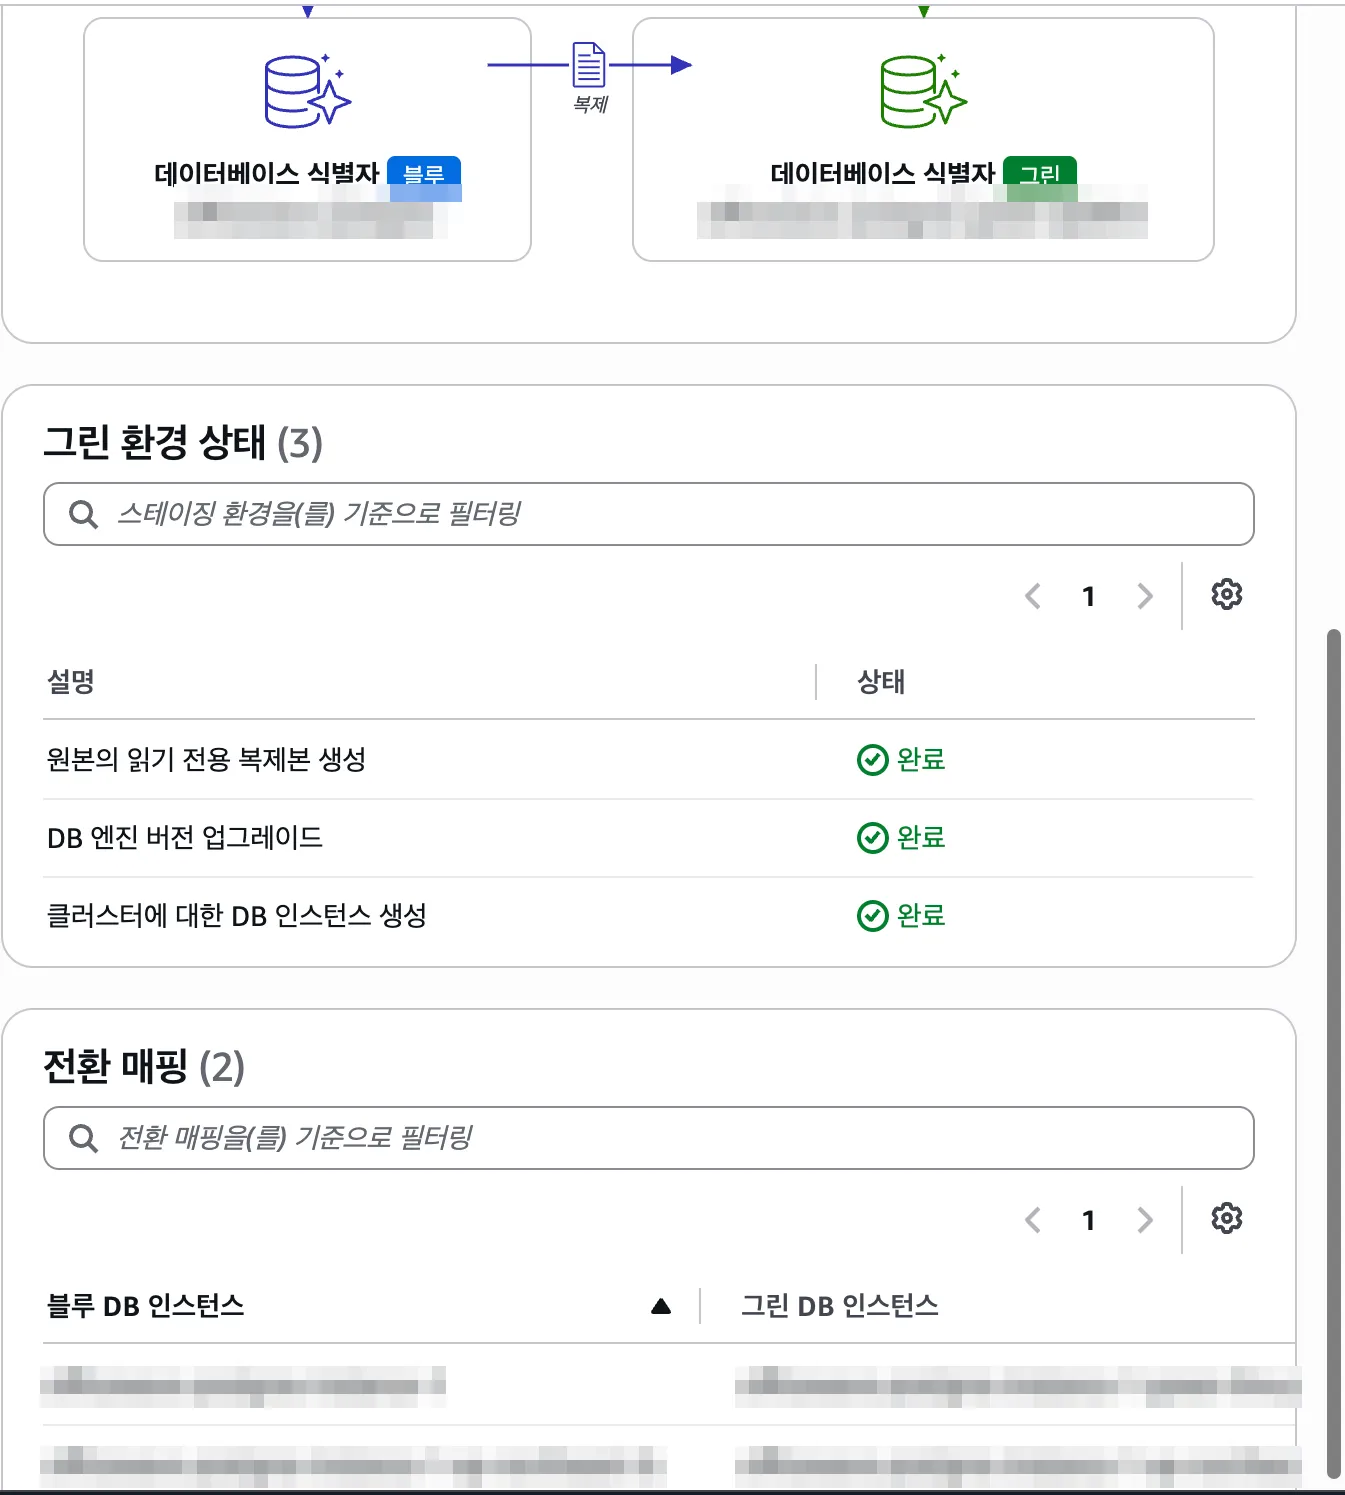
사용 가능이 되면 그린이 블루를 따라오는 중이라는 뜻이고, 그때부터 복제 지연을 본다. 블루 Writer 인스턴스의 모니터링 탭에서 OldestReplicationSlotLag 그래프를 보는 게 하나이고, 블루에서 직접 LSN 거리를 재는 쿼리가 둘이다.
SELECT slot_name,
       confirmed_flush_lsn AS flushed,
       pg_current_wal_lsn(),
       pg_size_pretty(pg_current_wal_lsn() - confirmed_flush_lsn) AS lag
FROM pg_catalog.pg_replication_slots
WHERE slot_type = 'logical';
slot_name | flushed | pg_current_wal_lsn | lag
---------------------------+---------------+--------------------+--------
rds_bg_apg15_to_16_app | 47D97/CF32980 | 47D97/CF3BAC8 | 36 kBlag은 수십 kB에서 수 MB 사이를 오가다 0으로 수렴하는 모양이어야 한다. 이 클러스터는 완료 뒤 콘솔의 복제 지연이 0 B로 붙어 있었다. 생성 직후엔 초기 동기화 때문에 크게 보여도 괜찮고, 문제는 방향이다.
그린의 apply 프로세스는 단일 스레드라서 블루가 초당 수천 건씩 쓰는 워크로드면 그린이 영영 못 따라올 수 있고, 그러면 스위치오버 가드레일에서 지연 초과로 막힌다. 배포를 만든 뒤 한두 시간 추이를 보고 계속 벌어지기만 하면 그린 인스턴스 클래스를 키우거나, 쓰기 피크를 피한 시간대에 배포를 다시 만드는 게 낫다. 슬롯이 아예 안 보이거나 active가 f면 복제가 끊긴 것이니 배포 상태와 이벤트부터 확인한다.
🧪 스위치오버 전 그린 검증 체크리스트
In-place와 결정적으로 다른 지점이다. In-place는 업그레이드가 끝난 운영 클러스터에서 ANALYZE를 돌리는 동안 서비스가 통계 없는 플래너를 견뎌야 하지만, Blue/Green은 그 작업을 스위치오버 전에 그린에서 끝낸다. 통계뿐 아니라 확장 버전과 인덱스까지 운영에 손대지 않고 미리 확인할 수 있다.
접속은 그린 클러스터를 열어 연결 및 보안 탭의 Writer 엔드포인트로 한다. 그린은 읽기 전용으로 묶여 있어 조회와 ANALYZE는 그냥 된다. 세션에서 default_transaction_read_only를 풀어 쓰기를 하는 건 하지 않는다. 전환이 롤백되면 그린에 쓴 데이터는 블루에 없기 때문이고, 쓰기가 필요한 작업(확장 업데이트, REINDEX)은 전환 뒤로 미룬다. 다섯 항목은 순서가 있다. 접속과 복제 상태를 먼저 확인해야 나머지가 의미 있다.
🔌 1. 접속·버전·파라미터
SELECT version();
SHOW shared_preload_libraries;
SHOW rds.logical_replication;
PostgreSQL 16.15, preload 목록에 pg_cron 없음, 논리 복제 on이어야 한다. 15가 찍히면 블루에 붙은 것이니 호스트에 -green-이 들어 있는지 본다. pg_cron이 보이거나 논리 복제가 off면 그린에 16 그룹이 제대로 안 붙은 것이다. 그린 클러스터를 수정해 apg16-cluster를 지정하고 그린 Writer를 재부팅한다. 그린 재부팅은 블루에 영향이 없다.
🔁 2. 복제 상태
-- 그린에서
SELECT subname, pid, received_lsn, latest_end_lsn, latest_end_time
FROM pg_stat_subscription;
데이터베이스마다 한 행씩 나오고 pid가 비어 있지 않아야 한다. latest_end_time이 지금 시각에 가까우면 따라오는 중이다. 블루 쪽에서는 앞 섹션의 LSN 거리 쿼리로 lag이 0에 붙어 있는지 본다.
콘솔에서도 네 가지가 맞아야 한다. 배포 상태 사용 가능, 그린 환경 상태 세 단계 모두 완료, 전환 매핑 두 줄 모두 사용 가능, 그리고 완료 이후 Replication degraded 이벤트 없음.
pid가 NULL인 subscription이 있으면 apply 워커가 죽은 것이고, 원인은 그린 Writer 인스턴스의 로그 및 이벤트 탭에 있는 PostgreSQL 로그에 찍힌다. 대부분 PK 없는 테이블에 UPDATE가 들어왔거나 블루에서 DDL이 실행된 경우라 배포를 다시 만들어야 한다.
📊 3. ANALYZE
pg_upgrade가 옵티마이저 통계를 옮기지 않는 건 그린에서도 마찬가지다. 그냥 두면 스위치오버 직후 멀쩡하던 인덱스 스캔이 seq scan으로 바뀐다. ANALYZE는 읽기 전용 트랜잭션에서도 돌아가니 DBeaver나 psql로 그린 Writer 엔드포인트에 붙어 데이터베이스마다 실행한다. 접속한 데이터베이스만 처리되므로 데이터베이스가 셋이면 세 번 붙어서 세 번 돌린다.
ANALYZE VERBOSE;VERBOSE를 붙이면 테이블 이름이 하나씩 찍혀서 진행 상황이 보인다. 데이터가 수백 GB라 한 번에 돌리기 부담스러우면 통계 목표치를 낮은 값부터 올려 세 번 돌린다. 첫 바퀴가 몇 분 안에 끝나 최소한의 통계부터 생기고, 마지막 바퀴가 정확한 통계를 만든다.
SET default_statistics_target = 1;   ANALYZE;
SET default_statistics_target = 10;  ANALYZE;
RESET default_statistics_target;     ANALYZE;
같은 VPC에 배스천이 있고 psql이 깔려 있다면 vacuumdb --all --analyze-in-stages가 이 세 바퀴를 모든 데이터베이스에 한 번에 돌려 주지만, 없으면 위 SQL로 충분하다.
끝난 뒤 통계가 진짜 채워졌는지는 데이터베이스마다 이 조회로 본다.
SELECT schemaname, relname
FROM pg_stat_user_tables
WHERE COALESCE(last_analyze, last_autoanalyze) IS NULL;
0건이어야 한다. 남는 테이블이 있으면 그 테이블만 ANALYZE schema.table;로 직접 돌린다. 파티션 테이블은 부모를 ANALYZE해야 파티션 간 플래닝 통계가 채워지므로, 이 조회에 부모 테이블이 남아 있으면 자식만 돌아간 것이다.
🧩 4. 확장 버전
메이저 업그레이드는 확장을 올리지 않는다. 그린에서는 어떤 확장이 올라가야 하는지만 조회로 확인하고, 실제 ALTER EXTENSION ... UPDATE는 전환 뒤 새 운영 클러스터에서 돌린다. 그린에서 하려면 읽기 전용을 풀어야 하는데, 그건 앞에서 말한 대로 하지 않는다.
SELECT name, installed_version, default_version
FROM pg_available_extensions
WHERE installed_version IS NOT NULL
  AND installed_version <> default_version;
확장은 데이터베이스별로 설치되므로 이 조회도 데이터베이스마다 돌려 목록을 적어 둔다. 0건이면 전환 뒤 할 일이 없다. PostGIS를 쓴다면 전환 뒤 SELECT postgis_extensions_upgrade(); 한 번으로 관련 확장을 한꺼번에 올릴 수 있다. 이 클러스터는 PostGIS를 쓰지 않아 목록이 짧았다.
🧱 5. 인덱스와 collation
인덱스가 “있는지”는 볼 필요가 없다. 그린은 블루의 클론이라 전부 있다. 봐야 할 건 무효 인덱스와 collation 버전이다.
SELECT indexrelid::regclass FROM pg_index WHERE NOT indisvalid;

SELECT datname, datcollversion,
       pg_database_collation_actual_version(oid) AS actual
FROM pg_database
WHERE datallowconn;
첫 조회는 0건, 두 번째는 datcollversion과 actual이 같아야 한다.
메이저 업그레이드로 OS의 문자 정렬 라이브러리 버전이 바뀌면 두 값이 달라지고, 텍스트 컬럼 B-tree 인덱스의 정렬이 실제 정렬과 어긋나 조회 결과가 빠지는 일이 생긴다. 불일치가 나오면 전환 직후 할 일로 적어 둔다. 텍스트 컬럼 인덱스를 REINDEX INDEX로 다시 만들고(수가 많으면 REINDEX DATABASE), 끝난 뒤 ALTER DATABASE dbname REFRESH COLLATION VERSION;으로 버전을 맞춘다. REINDEX는 무거우니 전환 당일 트래픽이 낮은 구간에 이어서 돌린다.
무효 인덱스는 보통 블루에서 실패한 CREATE INDEX CONCURRENTLY가 남긴 것이라 블루에도 있다. 역시 전환 뒤 REINDEX INDEX로 살린다.
다섯 항목 중 하나라도 걸리면 스위치오버를 미룬다. ANALYZE는 데이터베이스마다 따로이고, 그린에 만든 통계는 스위치오버 때 그대로 운영이 된다.
🚀 스위치오버
🚧 가드레일
스위치오버를 걸면 Aurora가 먼저 양쪽 환경을 점검한다. 하나라도 걸리면 시작하지 않는다.
- 그린: 복제 상태가 정상인지, 지연이 타임아웃 안에 따라잡을 범위인지, 그린에 쓰기가 없는지
- 블루: 외부 논리 복제가 없는지, 오래 도는 쓰기 트랜잭션이나 DDL이 없는지, 배포 기간 중 DDL과 대용량 객체 변경이 없었는지
마지막 항목에 걸리면 상태가 Replication degraded로 바뀌고 스위치오버 자체가 비활성화된다. 이 경우 해법은 배포를 그린까지 함께 지우고 다시 만드는 것뿐이다.
🔀 실행과 진행 순서
데이터베이스 목록에서 배포 행을 선택하고 작업 메뉴의 전환을 누른다. 전환 화면에는 블루와 그린의 클러스터·인스턴스 목록이 나란히 나오는데, 이름이 예상과 다르면 취소한다. 제한 시간 설정에 초 단위로 타임아웃을 넣고, 전환 전 권장 사항 확인란을 체크한 뒤 전환을 누른다.
전환을 누르면 “RDS가 트래픽을 블루에서 그린으로 전환하고 있습니다”라는 대화상자가 뜨고, 블루 데이터베이스에서 전환 준비와 읽기 전용 복제본 전환 두 줄이 진행 중으로 표시된다. 닫아도 전환은 계속되고, 배포 행의 상태로 이어서 본다.
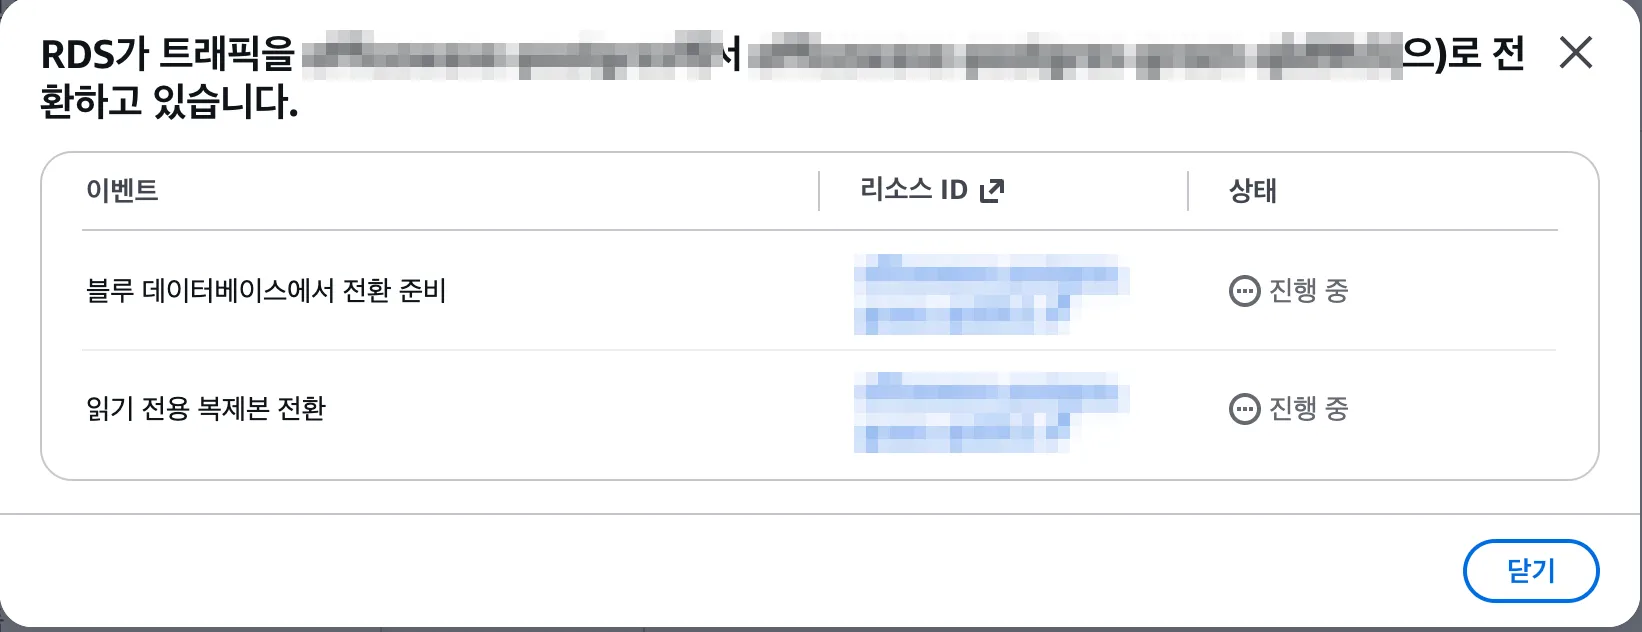
타임아웃은 기본 300초이고 30초에서 3,600초 사이로 지정한다. 안에 끝나지 않으면 전부 롤백되고 양쪽 환경 모두 손대지 않은 상태로 돌아온다. 시퀀스가 수십만 개 단위면 넉넉히 준다.
가드레일을 통과한 뒤의 순서는 이렇다.
- 블루와 그린 양쪽에서 새 쓰기를 막는다.
- 양쪽의 기존 연결을 끊고 새 연결을 거부한다. 앱에는
AdminShutdown: terminating connection due to administrator command로 보인다. - 그린이 블루를 완전히 따라잡을 때까지 기다리고, 시퀀스 값을 블루에 맞춘다.
- 그린 클러스터·인스턴스·엔드포인트 이름을 블루의 것으로 바꾸고, 블루는
-old1을 붙인다. - 양쪽 연결을 다시 열고 새 운영(구 그린)에 쓰기를 허용한다.
배포 행의 상태가 전환 진행 중을 거쳐 전환 완료로 끝난다. 전환 실패가 나오면 가드레일에 걸렸거나 타임아웃을 넘긴 것이고, 서비스는 블루에서 그대로 돈다. 이벤트 화면에 사유가 나온다. 지연 초과면 lag이 0에 붙을 때까지 기다렸다 다시 걸고, 오래 도는 트랜잭션이면 pg_stat_activity에서 찾아 끝낸 뒤 다시 건다. Replication degraded면 재시도로는 안 풀리고 배포를 그린까지 지우고 다시 만들어야 한다.
⏰ 실행 시점에서 지킬 것
- 쓰기 트래픽이 가장 낮은 시간이어야 한다. 배치와 긴 트랜잭션은 미리 세운다. 오래 도는 쓰기가 있으면 가드레일에 걸리거나 전환 시간이 늘어난다.
- 클라이언트와 네트워크 어디에서도 DNS 캐시 TTL을 Aurora 기본값인 5초보다 길게 잡고 있으면 안 된다. 길면 스위치오버 뒤에도 쓰기가
-old1로 간다. JVM은 기본 캐시가 길어서 특히 확인한다. - 연결 수가 많다면 상태가 전환 진행 중으로 바뀌는 걸 감지해 커넥션 풀을 비우는 스크립트를 미리 준비해 둔다.
앱 입장에서 스위치오버는 “연결이 끊겼다가 같은 엔드포인트로 다시 붙으니 16이었다”로 끝나야 한다. 재연결 재시도가 없는 앱이라면 그 1분이 장애가 된다.
RDS Proxy를 쓰는 경우 블루가 읽기 전용으로 바뀐 뒤 그린이 승격되기까지의 짧은 구간에 프록시가 블루로 계속 라우팅하므로, 그 사이 쿼리는 같은 AdminShutdown 에러를 받는다. 승격이 감지되면 프록시가 그린으로 돌리고 기존 연결은 끊기니, 프록시가 있어도 재연결 로직은 필요하다.
✅ 스위치오버 후 정리
새 운영 클러스터에 붙어 버전부터 확인한다.
SELECT version();
SHOW rds.logical_replication;
PostgreSQL 16.15 on aarch64-unknown-linux-gnu, compiled by ...
rds.logical_replication
-------------------------
on여기서 15가 찍히면 업그레이드가 안 된 게 아니라 -old1에 붙은 것이다. 클라이언트나 중간 리졸버의 DNS 캐시가 옛 주소를 들고 있는 경우라서, 캐시를 비우고 다시 붙으면 16이 나온다. 앱 서버 중 일부만 15에 붙어 있으면 그 서버들의 쓰기는 읽기 전용인 -old1에서 실패하고 있을 테니 바로 재기동한다. 논리 복제가 off면 그린에 16 파라미터 그룹이 제대로 안 붙은 것이고, CDC를 다시 붙이기 전에 그룹을 교정하고 재부팅한다.
그다음은 Aurora가 대신 해 주지 않는 것들이다.
🧩 확장 업데이트와 미뤄 둔 인덱스 작업
그린 검증 4번에서 적어 둔 확장을 데이터베이스마다 올린다. 전환이 끝난 새 운영 클러스터는 쓰기가 열려 있으니 세션 설정을 건드릴 필요가 없다.
ALTER EXTENSION pg_stat_statements UPDATE;
-- PostGIS를 쓴다면
SELECT postgis_extensions_upgrade();
extension "x" has no update path 에러가 나면 그 확장이 Aurora 16에서 그 경로를 제공하지 않는 것이다. pg_available_extension_versions에서 16이 가진 버전을 확인해 UPDATE TO 'version'으로 명시한다. 검증 5번에서 collation 불일치나 무효 인덱스가 나왔다면 REINDEX와 REFRESH COLLATION VERSION도 이때 돌린다.
🗑 배포 리소스 삭제와 old1 보존
배포 행을 선택해 작업 메뉴의 삭제를 누른다. 전환이 끝난 배포는 리소스만 지워지고 -old1 클러스터는 남는다.
새 운영 클러스터의 PITR 이력은 그린을 만든 시점부터 새로 시작된다. 그 이전 시점으로 돌아가야 할 상황에 대비해 복구 요구 기간만큼은 -old1을 지우지 않는다. 며칠 안정적으로 돌아가는 걸 보고 나서 배포 리소스와 함께 정리한다. 스위치오버 뒤의 old1은 읽기 전용으로 고정돼 있어 실수로 거기에 쓸 일은 없다.
🔗 떨어져 나간 것 다시 붙이기
- IAM 역할(S3 import·Lambda 호출용)은 그린으로 복사되지 않는다. 새 클러스터의 연결 및 보안 탭 아래 IAM 역할 관리에서 다시 추가한다.
- Auto Scaling 정책도 복사되지 않으니 다시 만든다.
- Performance Insights, CloudTrail, IAM 정책에서 리소스 ID로 필터링하던 곳은 새 DbClusterResourceId로 바꾼다. 이름은 같아졌지만 리소스 ID는 그린의 것이다.
🔛 껐던 것 켜기
- 새 운영 클러스터 파라미터 그룹(
apg16-cluster)의 preload 목록에pg_partman_bgw와 pg_cron을 다시 넣고 Writer를 재부팅한다. cron job 목록이 전환 전에 뽑아 둔 것과 같은지 확인한다. - pglogical을 쓰던 구조면 다시 설치한다.
- CDC 슬롯과 subscription, DMS 작업을 새 클러스터에서 처음부터 만든다.
- 배포 기간 동안 미뤄 뒀던 materialized view refresh를 돌린다.
🔧 논리 복제 파라미터는 되돌리나
워커·프로세스·WAL sender 값은 되돌리지 않아도 된다. 셋 다 상한값이라 복제를 안 쓰면 실제로 쓰이지 않고, 되돌리려면 정적 파라미터라 재부팅이 또 필요하다. 다음 메이저 업그레이드 때 또 Blue/Green을 쓸 거라면 그대로 두는 편이 낫다. 어느 쪽이든 전환 전에는 절대 건드리지 않는다. 복제가 이 값들로 돌아가고 있다.
rds.logical_replication은 다르다. 켜 두면 WAL 생성량이 늘어나는 오버헤드가 계속 남으니, DMS나 Debezium 같은 외부 논리 복제를 안 쓴다면 끄는 게 낫다. 바꿀 곳은 새 운영이 쓰는 16 그룹이다. 순서는 남은 슬롯 정리, 16 그룹에서 0으로 변경, Writer 재부팅, 확인이다.
SELECT slot_name, slot_type, active, database FROM pg_replication_slots;  -- 필요 없는 슬롯은 먼저 삭제, 활성 슬롯은 삭제 불가
SHOW wal_level;  -- 재부팅 뒤 replica 면 꺼진 것
⚠️ 16에서 앱이 걸릴 수 있는 변경점
PostgreSQL 16 자체의 비호환 변경은 많지 않지만 아래 넷은 운영 환경에서 실제로 걸린다.
CREATEROLE 권한 축소. 16부터는 CREATEROLE만 가진 롤이 다른 롤을 수정하거나 멤버를 추가하려면 해당 롤에 대한 ADMIN OPTION이 있어야 하고, CREATEDB·REPLICATION·BYPASSRLS를 부여하려면 본인도 그 권한을 들고 있어야 한다. 배포 스크립트가 서비스 계정을 자동 생성하는 구조라면 스위치오버 직후 권한 에러로 터질 수 있다.
롤 상속 규칙 변경. GRANT role TO member로 추가되는 멤버십의 상속 여부가 멤버 롤의 INHERIT 설정을 따르게 됐고, 이후 롤의 INHERIT를 바꿔도 기존 멤버십에는 영향을 주지 않는다. 필요하면 GRANT ... WITH INHERIT TRUE로 명시한다.
REINDEX DATABASE 범위 축소. 시스템 카탈로그 인덱스를 더는 건드리지 않는다. 카탈로그까지 돌리던 운영 스크립트는 REINDEX SYSTEM을 따로 호출해야 한다.
PL/pgSQL 커서 이름. 바운드 커서 변수의 포털 이름이 OPEN 시점에 할당되면서 변수명과 더는 일치하지 않는다. 커서 이름을 문자열로 조립해 쓰던 코드가 있다면 깨진다.
반대로 얻는 것도 분명하다. pg_stat_io 뷰로 I/O 통계를 백엔드 유형별로 볼 수 있고, FULL·RIGHT OUTER 해시 조인이 병렬화되며, string_agg와 array_agg가 병렬 집계를 탄다. 논리 디코딩을 스탠바이에서 할 수 있게 된 것도 CDC 파이프라인을 Reader로 옮길 수 있다는 점에서 운영상 큰 변화다.
📝 정리
콘솔이 대신 해 주는 것과 끝까지 사람 손이 가는 것을 먼저 갈라 두면 일정 잡기가 쉽다.
| 작업 | 자동 | 수동 |
|---|---|---|
| 논리 복제 파라미터 변경 | ✅ | |
| 블루 Writer 재부팅 | ✅ | |
| 블루 Reader 재부팅 | ✅ | |
| 16용 파라미터 그룹 생성 | ✅ | |
| 슬롯·워커 수 조정(데이터베이스 수에 맞춰) | ✅ | |
| 그린 환경 프로비저닝(클론 + pg_upgrade) | ✅ | |
| 데이터 실시간 복제 | ✅ | |
| ANALYZE 실행 | ✅ | |
| 확장 버전 업데이트 | ✅ | |
| 쿼리·데이터 검증 | ✅ | |
| 스위치오버 실행 | ✅ |
자동 칸의 앞 두 줄은 배포 생성 화면의 블루 파라미터 그룹 수정 확인란을 체크했을 때 기준이다. 그 자동이 넣어 주는 값은 논리 복제 on 하나뿐이라, 데이터베이스가 넷 이상이면 슬롯·워커 수를 손으로 올리지 않는 한 생성이 실패한다.
Blue/Green 기준으로 순서를 다시 적으면 이렇다.
- PK 없는 테이블·대용량 객체·unlogged 테이블·외부 논리 복제 슬롯 점검, pg_partman_bgw·pglogical 제거와 파티션 선생성, 16 그룹에서 pg_cron 제외, PostGIS 계열 확장 선업데이트
- 데이터베이스 수 확인, 15·16 클러스터 그룹에 논리 복제 on과 워커·프로세스·WAL sender 값 설정, Reader와 Writer 재부팅 후 동기화 중 확인
- 작업 메뉴의 블루/그린 배포 생성으로 그린 생성, 모니터링 탭의 OldestReplicationSlotLag로 지연이 수렴하는지 확인
- 그린 검증 5항목: 버전·파라미터, 복제 상태, 데이터베이스별 ANALYZE, 확장 버전 조회, 무효 인덱스·collation 조회
- 쓰기 최저 시간대에 작업 메뉴의 전환, 타임아웃 지정 후 앱 재연결 확인
- 확장 업데이트와 미뤄 둔 REINDEX, IAM 역할·Auto Scaling·CDC·DMS 재설정, 논리 복제 파라미터 정리,
-old1과 배포 리소스는 며칠 안정 확인 뒤 삭제
관리형 서비스라서 버튼 하나로 끝날 것 같은 작업일수록 서비스가 대신 해 주지 않는 부분이 어디인지 아는 게 핵심이다. DocumentDB를 MongoDB처럼 다루다 막혔던 경험과 같은 맥락이다. Blue/Green은 클론과 업그레이드, 복제, 이름 바꿔치기까지 해 주지만, 복제가 못 옮기는 걸 미리 치우고, 통계를 채우고, 스키마 동결을 지키게 하고, 스위치오버 뒤 떨어져 나간 것들을 다시 붙이는 일은 끝까지 운영자의 몫이다.
관련 글
S3 비용 최대 80% 절감, Intelligent-Tiering 설정
S3 Intelligent-Tiering이 모든 버킷의 정답은 아니다. 서울 리전 단가로 손익분기 객체 크기를 계산하고, 라이프사이클 적용부터 검증, 티어가 안 내려가는 함정까지 정리했다.
PHP2Shell 취약점 CVE-2026-109618 원리·공격·방어
PHP 5.4부터 8.5.11까지 전부 걸린 인증 없는 RCE, PHP2Shell. 두 CVE가 어디서 터지는지, 왜 mod_php가 가장 위험한지, 패치·임시 완화·침해 점검을 명령어와 함께 정리했다.